
⚠️ Einige Passagen erläutern technische Details. Das Symbol ⚠️ kennzeichnet optionale Absätze oder ganze Abschnitte. Sie können diese überspringen, wenn Sie lieber dem übergeordneten Gedankengang folgen möchten; die Kernaussage bleibt verständlich.
Einführung
Software kann fertig erscheinen, lange bevor ihr Verhalten unter widrigen Bedingungen geklärt ist. KI-gestützte Tools können zwar schnell Benutzeroberflächen und funktionierende Features entwickeln, doch eine Demonstration testet lediglich die vorgegebenen Pfade. Sie sagt wenig darüber aus, ob eine Anfrage vom falschen Konto abgelehnt wird, ob eine fehlerhafte Datei einen schwerwiegenden Fehler auslösen kann oder ob eine ausgefallene Abhängigkeit Informationen offenlegt. Der Nachweis nützlichen Verhaltens und die Festlegung verlässlicher Grenzen erfordern andere Nachweise.
Ein System muss seine Grenzen trotz fehlerhafter Anweisungen, gestohlener Zugangsdaten, sich ändernder Zustände und gezielter Versuche, es zum Ausfall zu bringen, durchsetzen. Diese Grenzen erstrecken sich über die sichtbaren Funktionen der Anwendung hinaus und umfassen Identitätssysteme, privilegierte Dienste, Bibliotheken, Betriebssysteme, Hardware und Wartung. Jede Komponente mag sich scheinbar korrekt verhalten, doch eine fehlerhafte Entscheidung zwischen ihnen kann zu schädlichen Folgen führen.
Sicherheit wird üblicherweise im Zusammenhang mit Vertraulichkeit, Integrität und Verfügbarkeit diskutiert: Verhinderung unbefugter Offenlegung und Veränderung sowie Sicherstellung der Nutzbarkeit von Diensten unter definierten Bedingungen. Diese Begriffe beschreiben Ergebnisse, nicht Schutzmaßnahmen. Eine Patientenakte, ein Kontostand und ein Fahrplan unterliegen jeweils unterschiedlichen Regeln und Konsequenzen. Die Arbeit beginnt mit der Identifizierung der zu schützenden Daten, der potenziell schutzbedürftigen Handlungen und ihrer möglichen Folgen. Auch das Sammeln und Aufbewahren weniger sensibler Informationen kann den Schaden eines späteren Datenlecks verringern, selbst bei ansonsten soliden Zugriffskontrollen. [1]
Eine Sicherheitsmaßnahme ist nur so nützlich wie die Vorgänge, die sie tatsächlich schützt. Eine Website kann einen unautorisierten Download blockieren, während eine Exportfunktion denselben Datensatz freigibt. Verschlüsselung kann eine Datei schützen, während der Entschlüsselungsschlüssel für Unbefugte zugänglich ist. Eine Anwendung kann eine Datei genehmigen und anschließend eine weitere unter demselben Namen öffnen. In jedem dieser Fälle kann eine lokale Schutzmaßnahme fälschlicherweise den Eindruck erwecken, der gesamte Vorgang sei geschützt.
Ein Bedrohungsmodell identifiziert, was Schutz benötigt, was ein Angreifer verändern kann, wo privilegierte Entscheidungen getroffen werden und welche Annahmen möglicherweise nicht zutreffen. Es hilft, mögliche Angriffswege aufzuzeigen, ohne jedoch zu behaupten, jeden Angriff vorhersagen zu können. [2]
Die Identifizierung dieser Wege deckt auch die Angriffsfläche des Systems auf: die Stellen, an denen ein Angreifer Eingaben machen, Operationen anfordern oder Informationen erlangen könnte. Netzwerkdienste, Anmelde- und Verwaltungsschnittstellen sowie Dateiimportfunktionen sind mögliche Einfallstore, selbst wenn sie nicht sofort ersichtlich sind. Die Reduzierung dieser Angriffsfläche bedeutet, unnötige Funktionen und Dienste zu deaktivieren, den Zugriff auf die verbleibenden Funktionen und Dienste einzuschränken und nicht benötigte Berechtigungen zu verweigern. Weniger exponierte Pfade verringern die Angriffsmöglichkeiten, doch die verbleibenden Pfade erfordern weiterhin regelmäßige Überprüfungen und Wartung.
Wo die Sicherheit zuerst versagt
Viele schwerwiegende Vorfälle erfordern keine außergewöhnlichen Techniken. Es existieren weiterhin Konten mit vom Hersteller bereitgestellten Passwörtern, die zwischen Personen weitergegeben oder für verschiedene Dienste wiederverwendet werden. Sobald ein Angreifer ein solches Passwort kennt, kann das System die Anmeldung wie vorgesehen akzeptieren. Passwort-Raten, automatisierte Versuche mit anderweitig erlangten Zugangsdaten und betrügerische Anfragen nach Einmalcodes nutzen Schwachstellen im Bereich der Identitätsprüfung aus, anstatt Fehler im Code, der Passwörter überprüft. Einzigartige, schwer zu erratende Zugangsdaten, eine zuverlässige Kontowiederherstellung, Ratenbegrenzungen und stärkere Anmeldemethoden können diese Möglichkeiten verringern. Multi-Faktor-Authentifizierung und Passkeys bieten wichtigen Schutz, aber keine Anmeldemethode kann selbstständig entscheiden, ob eine nach der Anmeldung erteilte Anweisung sinnvoll oder legitim ist. [3] [4]
Manchmal vergessen Nutzer ihr Passwort oder verlieren das Gerät, mit dem sie sich anmelden. Ein Dienst benötigt daher eine Möglichkeit, ihnen den Zugriff wieder zu ermöglichen, muss aber gleichzeitig den rechtmäßigen Kontoinhaber von einem unbefugten Nutzer unterscheiden. Wenn zum Zurücksetzen des Zugriffs lediglich leicht zugängliche Informationen benötigt werden, kann ein Betrüger selbst starke Anmeldesicherheitsvorkehrungen umgehen. Die Kontowiederherstellung muss daher legitimen Nutzern einen praktischen Weg zurück zum Konto bieten, ohne Angreifern einen einfacheren Zugang zu ermöglichen.
Die Anmeldung ist nur der Anfang des Kontoschutzes. Um nicht für jede Aktion ein Passwort oder einen Passkey abfragen zu müssen, stellen viele Dienste eine Sitzungs-ID oder ein Zugriffstoken aus, das eine authentifizierte Sitzung repräsentiert. Erlangt ein Angreifer ein solches wiederverwendbares Attribut, kann der Dienst Anfragen im Namen des angemeldeten Kontos akzeptieren, ohne die ursprünglichen Anmeldedaten erneut abzufragen. Dies wird als Session Hijacking bezeichnet. Die Sicherheit hängt daher davon ab, wie Sitzungen ausgestellt, gespeichert, eingeschränkt, abgelaufen und widerrufen werden, insbesondere nach einem vermuteten Angriff oder der Wiederherstellung eines Kontos. Ein starker Anmeldeschutz und der Schutz der nach der Anmeldung verbleibenden Berechtigungen sind unterschiedliche Aufgaben. [5]
Social Engineering greift den menschlichen Faktor bei Entscheidungen an. Eine Nachricht kann behaupten, ein Lieferant habe seine Bankverbindung geändert, ein Konto müsse dringend verifiziert werden oder ein Dokument warte hinter einer Anmeldeseite. Der schädliche Link kann zu einer überzeugenden Nachahmung eines legitimen Dienstes führen, oder ein Download versucht, eine Sicherheitslücke in einer Anwendung auszunutzen. Das bloße Öffnen einer Webseite bedeutet nicht automatisch, dass man sein Konto preisgibt oder einen Computer infiziert: Das Ergebnis hängt vom Ziel, den Schutzmechanismen des Browsers und des Geräts, der Softwareversion und den weiteren Aktionen ab. Entscheidend ist der Unterschied zwischen einer Seite, die über eine geschützte Verbindung empfangen wird, und der Vertrauenswürdigkeit der Seite selbst. Verschlüsselung schützt zwar Daten während der Übertragung zur tatsächlich aufgerufenen Webseite, sie kann aber nicht bestätigen, dass es sich um die vom Nutzer beabsichtigte Webseite handelt. [3]
Phishing ist nicht einfach nur ein Test, ob jemand verdächtige Nachrichten erkennt. Zhuo et al. analysierten in ihrem 2023 veröffentlichten Wissensbericht 52 empirische Studien und ordneten die Anfälligkeit für Phishing-Angriffe nach individuellen Merkmalen, situativen Bedingungen und den Umständen des Nachrichtenempfangs. Die Ergebnisse lassen kein allgemeingültiges Profil derjenigen zu, die sich täuschen lassen. Schutzmaßnahmen kombinieren daher geeignete Authentifizierung, benutzerfreundliches Interface-Design, Bestätigungsverfahren für wichtige Anweisungen und Schulungen, anstatt sich allein auf Wachsamkeit zu verlassen. [6]
Konfigurationen können ein System entweder unnötig angreifbar machen oder den Zugriff eines Angreifers einschränken. Ein für ein bestimmtes Team vorgesehener Ordner kann öffentlich zugänglich sein, eine Verwaltungsschnittstelle kann über das Internet erreichbar sein, obwohl sie intern sein sollte, eine Datenbank kann Standardanmeldeinformationen beibehalten oder eine Testumgebung kann echte Daten unter schwächeren Sicherheitsvorkehrungen enthalten. Dies sind Fehlkonfigurationen: Die Software kann sich zwar genau wie programmiert verhalten, ihre Einstellungen erlauben jedoch Zugriffe oder Aktionen, die nie vorgesehen waren. Unsichere Standardeinstellungen, kopierte Einstellungen und angehäufte Ausnahmen tragen alle zu diesem Risiko bei.
Eine gezielte Konfiguration kann die Angriffsfläche verringern. Dies wird als Härtung bezeichnet: Dabei werden nur die notwendigen Dienste und Funktionen aktiviert, der Zugriff darauf eingeschränkt und die Wirksamkeit dieser Einschränkungen überprüft. Ein SSH-Dienst zur Fernadministration eines Servers kann beispielsweise auf autorisierte Konten und genehmigte Netzwerkpfade beschränkt, so konfiguriert werden, dass die direkte Root-Anmeldung auf Unix-ähnlichen Systemen nicht möglich ist, und gegebenenfalls die Anmeldung per Schlüssel anstelle von Passwörtern verwenden. Wird die Fernadministration nicht benötigt, kann SSH vollständig deaktiviert werden. Diese Maßnahmen schränken den Zugriff auf den Dienst ein oder entfernen ihn, können aber nicht garantieren, dass der verbleibende Code frei von Sicherheitslücken ist. Die Härtung muss zudem den legitimen Zugriff gewährleisten und auf dem tatsächlich eingesetzten System verifiziert werden. [4]
Zugangsdaten sind umfassender als Passwörter. Softwaredienste verwenden geheime Schlüssel und Zugriffstoken zur Kommunikation untereinander, und Mitarbeiter oder Auftragnehmer verfügen unter Umständen über weitreichende Administratorkonten. Ein versehentlich in einem Code-Repository veröffentlichter, in einem Protokoll gespeicherter oder nach Vertragsende mit einem Lieferanten aufbewahrter Schlüssel kann ohne jeglichen Versuch, die Verschlüsselung zu knacken, Zugriff gewähren. Verschlüsselung kann die Offenlegung nicht verhindern, wenn ein Angreifer den notwendigen Entschlüsselungsschlüssel erlangt oder einen Dienst kontrolliert, der zur Offenlegung des Klartextes berechtigt ist. Der Schutz gespeicherter Informationen hängt daher nicht nur vom Algorithmus, sondern auch von der Schlüsselverwaltung und dem Zugriff auf die Entschlüsselung ab. Organisationen gewähren ihren Mitarbeitern mitunter weit mehr Zugriffsrechte, als diese für ihre Aufgaben benötigen. Die angemessene Reaktion besteht darin, den Speicherort von Zugangsdaten zu kontrollieren, ihren Umfang einzuschränken, sie bei Nichtgebrauch zu entziehen und verdächtige Nutzungen zu erkennen. Protokolle können helfen, den Hergang zu rekonstruieren, jedoch können sie allein Missbrauch nicht verhindern und bei unachtsamer Gestaltung selbst sensible Informationen preisgeben. Die zugrundeliegende Problematik ist dieselbe wie bei Standardpasswörtern: Ein technisch gültiges Zugangsformular kann weit über den Zweck hinaus Berechtigungen verleihen, für den es ausgestellt wurde. [2]
Diese Fälle haben eine wichtige Gemeinsamkeit: Akzeptierte Anmeldeinformationen, eine plausible Nachricht oder eine zu einfache Einstellung können zu einer Aktion führen, die niemand autorisiert hat. Der Schutz dieser Entscheidung erfordert mehr als nur Warnungen zur Vorsicht. Dienste können das Rätselraten einschränken, risikoreiche Berechtigungen als Ausnahmen festlegen und eine unabhängige Bestätigung für weitreichende Änderungen bereitstellen. Eine weitere Herausforderung besteht darin, sicherzustellen, dass diese Kontrollen den tatsächlichen Betrieb gewährleisten, insbesondere wenn eine leistungsfähigere Komponente im Auftrag einer anderen Partei handelt.
Identität, Berechtigung und delegierte Befugnis
Die Authentifizierung legt fest, von welchem Konto oder welcher anderen Identität eine Anfrage zu stammen scheint. Die Autorisierung bestimmt, welche Aktionen diese Identität mit einem bestimmten Datensatz oder Vorgang ausführen darf. Ein Mitarbeiter kann korrekt angemeldet sein und dennoch kein Recht haben, die Dateien eines anderen Mitarbeiters zu lesen. Die Kenntnis einer Datensatznummer oder eines Links allein berechtigt nicht zum Abruf des Datensatzes. Ein System, das eine Exportschaltfläche ausblendet, aber die zugrundeliegende Schnittstelle zum Exportieren derselben Informationen freigibt, schützt die Benutzeroberfläche, nicht aber den Vorgang selbst. Jeder relevante Pfad, einschließlich direkter Anfragen, Hintergrundprozesse und interner Dienste, muss die notwendige Berechtigungsentscheidung bis zu dem Punkt durchführen, an dem der Schutz eintritt. [7]
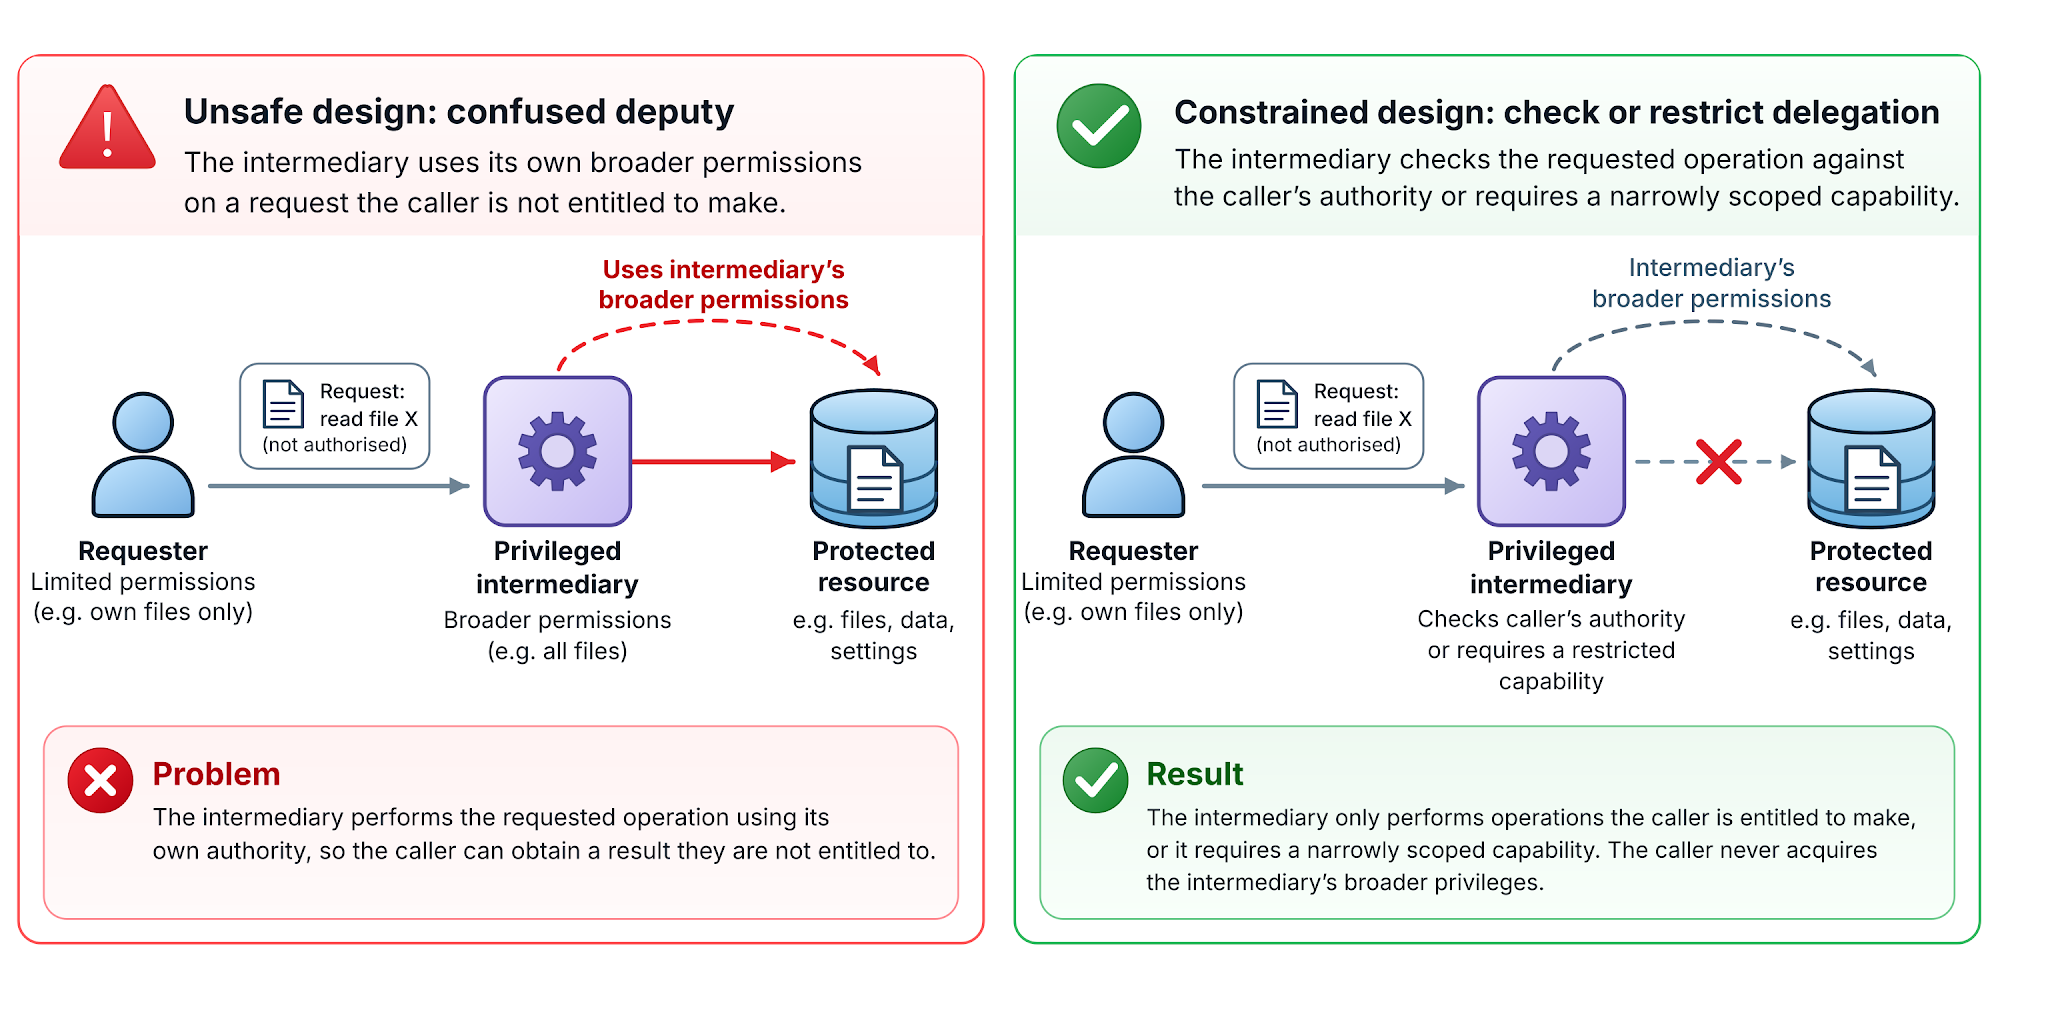
Das Confused-Deputy-Problem entsteht, wenn Software ihre eigenen, umfassenderen Berechtigungen nutzt, um eine Anfrage auszuführen, zu der der Aufrufer nicht berechtigt ist. Beispielsweise kann ein Datensatzdienst berechtigt sein, jede Datei zu lesen, während ein normaler Benutzer nur seine eigenen abrufen sollte. Akzeptiert der Dienst eine beliebige Datensatzkennung, ohne die Rechte des Aufrufers zu prüfen, kann er die Informationen einer anderen Person zurückgeben. Der Benutzer erlangt niemals die Master-Berechtigungen des Dienstes; der Dienst missbraucht sie im Namen des Benutzers. Die Isolierung der geschützten Datensätze ist daher unzureichend, wenn ein privilegierter Vermittler diese für jeden abrufen kann, der danach fragt. [8]
Eine gut durchdachte Delegierungsschnittstelle beschränkt die Aufgaben, die die privilegierte Komponente ausführen darf. Anstatt einen uneingeschränkten Dateipfad zu akzeptieren, kann sie eine spezifische, an die Rechte des Aufrufers gebundene, zulässige Operation oder eine eng definierte Berechtigung akzeptieren, die die Zuständigkeit für eine bestimmte Ressource nachweist. Dies entspricht dem Prinzip der minimalen Berechtigung: Konten, Komponenten und Dienste erhalten nur die Zugriffsrechte und Operationen, die für ihre Aufgaben erforderlich sind. Zudem wird der Wirkungsradius eines Fehlers begrenzt, d. h. die Informationen und Aktionen, die von einem Fehler betroffen sein können, auch über andere Komponenten, die bereit sind, in ihrem Namen zu handeln. Eine Komponente kann keinen direkten Zugriff auf private Dateien haben und diese dennoch indirekt über einen leistungsfähigeren Dienst offenlegen, wenn ihre Anfragen nicht ausreichend eingeschränkt sind. [9] [10]
Die Berechtigung kann nicht allein durch die technische Identität geklärt werden. Ein legitimer Mitarbeiter kann betrügerische Anweisungen zur Änderung von Zahlungsdaten erhalten, und ein autorisierter Administrator kann eine gefährliche Konfiguration genehmigen. Der Computer kann das Mitarbeiterkonto korrekt verifizieren, ohne jedoch die angegebene Herkunft der Geschäftsanfrage zu hinterfragen. Bei Änderungen mit weitreichenden Folgen kann die Bestätigung über unabhängig ermittelte Kontaktdaten die Gewissheit bieten, dass die Anweisung von der beabsichtigten Person stammt. Solche Verfahren helfen zwar bei betrügerischen Anweisungen, beheben aber nicht das Problem einer fehlenden Autorisierungsprüfung innerhalb der Anwendung. Unterschiedliche Schwachstellen erfordern unterschiedliche Schutzmaßnahmen.
Eine weitere Gefahr besteht im vorsätzlichen Missbrauch rechtmäßig gewährter Zugriffsrechte. Jemand kann korrekt angemeldet sein und sensible Daten einsehen dürfen, diese aber dennoch an Unbefugte weitergeben oder administrative Berechtigungen missbräuchlich verwenden. Authentifizierung und Autorisierung funktionieren zwar wie konfiguriert, lassen aber keine Rückschlüsse auf die Absichten einer Person zu. Eng gefasste Berechtigungen, die Trennung sensibler Aufgaben, die ordnungsgemäße Protokollierung von Folgemaßnahmen und unabhängige Überprüfungen können diese Art von Insidermissbrauch einschränken oder aufdecken. [11]
Die Berechtigung zur Durchführung einer Operation garantiert nicht, dass diese Operation in jeder Phase eines größeren Prozesses gültig ist. Eine Bestellung darf erst dann ausgeführt werden, wenn die erforderlichen Zahlungsbedingungen erfüllt sind. Ein für den einmaligen Gebrauch bestimmter Gutschein darf nicht wiederholt eingelöst werden, nur weil jede Anfrage korrekt formuliert ist und von einem berechtigten Konto stammt. Dies sind Fehler in der Geschäftslogik: Die Anwendung hat die Voraussetzungen, die gültige Reihenfolge oder die für die zugehörigen Aktionen geltenden Beschränkungen nicht durchgesetzt. Solche Regeln müssen beim jeweiligen Übergang anhand des maßgeblichen Zustands überprüft werden, anstatt sie aus einer angezeigten Ansicht oder einem vom Anfragenden angegebenen Schritt abzuleiten. Der Fehler kann auch ohne Race Condition, böswillige Befehle oder gestohlene Konten auftreten. [12]
Wenn eine korrekte Überprüfung nicht mehr zutrifft
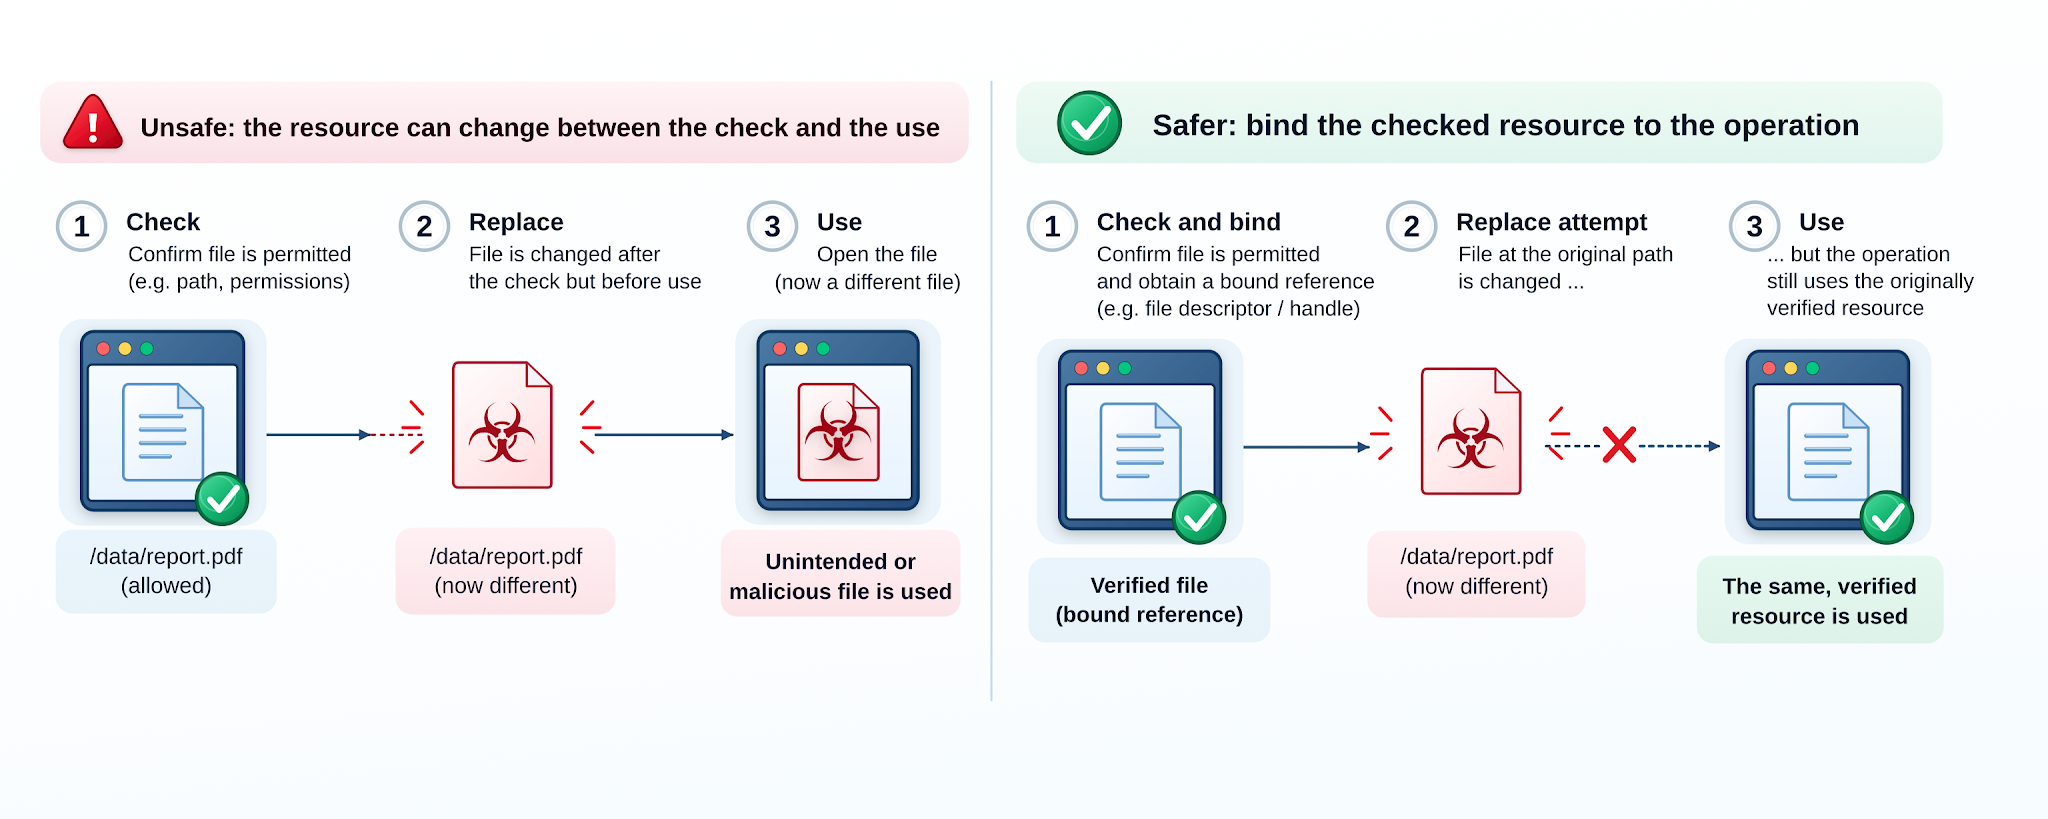
Eine Berechtigungsprüfung kann zum Zeitpunkt ihrer Durchführung korrekt sein und dennoch später keinen Schutz mehr bieten. Eine Datei kann genehmigt und anschließend ersetzt werden, bevor das Programm sie öffnet. Zwei Arbeitsprozesse können jeweils einen ausreichenden Lagerbestand feststellen und ihn anschließend beide abbuchen. Dies sind sogenannte TOCTOU-Probleme (Time-of-Check to Time-of-Use): Der geprüfte Zustand entspricht nicht mehr dem Zustand, auf dem die Folgeoperation ausgeführt wird. Sie stellen Sicherheitslücken dar, wenn Dritte diese Lücke ausnutzen können, um gegen eine erforderliche Regel zu verstoßen. Einige dieser Probleme entstehen durch parallele Operationen; andere betreffen Ressourcen, deren Identität oder Berechtigungen sich während der Ausführung ändern. [13]
Stellen Sie sich ein Programm vor, das einen Dateipfad mit einem freigegebenen Speicherort vergleicht und diesen Pfad später öffnet. Kann ein Angreifer die Pfadnamen in diesem Zeitraum ändern, verarbeitet das Programm möglicherweise eine andere Datei als die freigegebene. Abhilfe schafft, dass die Entscheidung für die tatsächlich genutzte Ressource und den tatsächlich verwendeten Zustand gilt. Je nach System kann dies bedeuten, mit einem bereits geöffneten und verifizierten Dateihandle zu arbeiten, eine atomare Operation oder Transaktion zu verwenden, eine geeignete Sperre zu setzen oder zu definieren, wie sich ein Widerruf auf bereits begonnene Arbeit auswirkt. Eine erneute Prüfung ohne Schließung der nächsten Lücke bietet keine Garantie.
Gleichzeitige Zugriffe können neben dem Dateizugriff weitere Fehler verursachen. Mehrere einzeln gültige Anfragen können gemeinsam ein Kontolimit überschreiten, wenn sie mit einem veralteten Status abgeglichen werden. Eine Berechtigung kann während der Ausführung eines langlaufenden Prozesses entzogen werden, oder eine Kennung kann neu zugewiesen werden, während eine andere Komponente davon ausgeht, dass sie sich weiterhin auf dasselbe Objekt bezieht. Ein sicheres Design muss festlegen, welcher Status maßgeblich ist und wie die Prüfung und die daraus resultierenden Operationen konsistent bleiben.
Wenn Informationen die Arbeit steuern dürfen
Programme verarbeiten Daten, die über Benutzeranfragen, importierte Dateien, Netzwerknachrichten und andere Dienste bereitgestellt werden. Ein Wert kann wohlgeformt sein und dennoch für die von ihm gesteuerte Operation ungeeignet sein. Ein Dateiname kann auf einen Pfad außerhalb des vorgesehenen Verzeichnisses verweisen. Eine Datensatzkennung kann die Daten einer anderen Person auswählen. Die Verarbeitung einer kleinen komprimierten Datei kann einen enormen Rechenaufwand verursachen. Solches Material als nicht vertrauenswürdige Eingabe zu bezeichnen bedeutet, dass die für den jeweiligen Verwendungszweck erforderlichen Eigenschaften noch nicht festgelegt sind. Es bedeutet nicht, dass jeder Absender böswillig ist. Derselbe Fehler kann durch absichtliche Manipulation, eine beschädigte Datei oder einen gewöhnlichen Fehler entstehen. [14]
Eine gefährliche Überleitung entsteht, wenn Daten zu einer Anweisung werden. Eine Datenbankabfrage oder ein Betriebssystembefehl, der durch die Verknüpfung von Programmtext mit einem externen Wert zusammengesetzt ist, kann dazu führen, dass dieser Wert den Befehl selbst verändert. Dies ist eine sogenannte Injection-Schwachstelle. Eine Webseite kann ähnlich versagen, wenn extern bereitgestellter Text in Inhalte eingebunden wird, die ein Browser als Code interpretiert, anstatt sie als Text anzuzeigen. Dies ist Cross-Site-Scripting (XSS). Um dies zu verhindern, muss der Inhalt für den spezifischen Kontext, in dem der Browser ihn interpretiert, behandelt werden. Sicherere Schnittstellen trennen die beabsichtigte Operation von den variablen Daten, beispielsweise durch die Verwendung parametrisierter Datenbankabfragen, sofern die Schnittstelle dies unterstützt. Die Lösung besteht nicht in einer allgemeinen Liste verdächtiger Zeichen: Ein Wert, der als Klartext sicher ist, kann unsicher sein, wenn er als Befehl, Dateipfad oder Teil einer anderen Sprache interpretiert wird. Selbst eine korrekt erstellte Datenbankabfrage erfordert eine separate Prüfung, ob der Anfragende berechtigt ist, das Ergebnis zu erhalten. [15] [16]
Manche schädliche Eingaben enthalten gar keinen Befehl. Ein Mediendecoder kann aufgefordert werden, mehr Speicher zuzuweisen als vorgesehen, ein komplexes Dokument kann übermäßig viel Verarbeitungszeit beanspruchen, und wiederholte zulässige Anfragen können einen gemeinsam genutzten Dienst überlasten. Ressourcenbeschränkungen müssen vor und während aufwändiger Operationen durchgesetzt werden, nicht erst, nachdem die Kosten bereits entstanden sind. Die Folge kann eine kontrollierte Ablehnung, ein Absturz oder ein Dienst sein, der für andere Benutzer nicht mehr verfügbar ist. Deshalb umfasst Sicherheit auch die Frage, ob Systeme ihre legitimen Aufgaben weiterhin erfüllen können. Die Bedingungen, unter denen ein Dienst seine Verfügbarkeit zusichert, und die Grenzen dieser Zusage verdienen ebenso viel Präzision wie seine Zugriffsregeln. [14]
Diese Fehler unterscheiden sich darin, wo nicht vertrauenswürdige Informationen eine Grenze überschreiten. Manchmal werden sie als Anweisung interpretiert, manchmal erschöpfen sie eine Ressource, und manchmal werden sie von Code verarbeitet, der seinen eigenen Speicher nicht sicher verwalten kann. Der letzte Fall erfordert besondere Beachtung, da eine fehlerhafte Datei oder Nachricht die Art und Weise ausnutzen kann, wie ein Programm Daten speichert und darauf zugreift, selbst wenn die Eingabe keinen Befehl enthält.
Speichersicherheit und Sprachgarantien
Jedes laufende Programm benötigt Arbeitsspeicher. Das Programm speichert Werte in dafür vorgesehenen Bereichen, verwendet diese Werte und gibt schließlich nicht mehr benötigten Speicherplatz frei. Eine Grundvoraussetzung ist, dass eine Operation nicht außerhalb des ihr zugewiesenen Bereichs lesen oder schreiben darf. Eine weitere Voraussetzung ist, dass Speicher nicht weiter verwendet werden darf, als gehöre er zu einem Objekt, dessen Lebensdauer abgelaufen ist. Diese beiden Schutzmechanismen sind zentral für die Speichersicherheit. Sie betreffen die Gültigkeit von Speicheroperationen und nicht die Frage, ob eine Person ursprünglich berechtigt war, diese Operationen anzufordern.
Der Aktenverwalter (siehe „Wie Computer funktionieren: Feynmans Hochgeschwindigkeits-Aktenverwalter“) bietet eine direkte Analogie. Ein Ablagefach bietet Platz für 100 Karteikarten, aber eine Anweisung verlangt 120. Ohne eine Regel, die die Grenzen des Fachs festlegt, könnten die zusätzlichen Karteikarten dort abgelegt werden, wo andere Datensätze hingehören. In einem Computer kann ein unkontrollierter Schreibvorgang über einen zugewiesenen Bereich hinaus fremde Daten beschädigen; ein unkontrollierter Lesevorgang kann Informationen aus einem anderen Bereich offenlegen. Je nach Programm und den vorhandenen Schutzmechanismen können die Folgen von einem Absturz oder einem falschen Ergebnis bis hin zu einer Sicherheitslücke reichen, die ein Angreifer ausnutzen kann. Ein kontrollierter Vorgang verhindert hingegen den ungültigen Zugriff. Die angeforderte Ablageaufgabe kann fehlschlagen, aber diese spezielle Grenze bleibt erhalten. Die Karteikarten sind eine Metapher für Speicherorte und bedeuten nicht, dass jeder Überlauf automatisch einem Angreifer die Kontrolle verschafft.
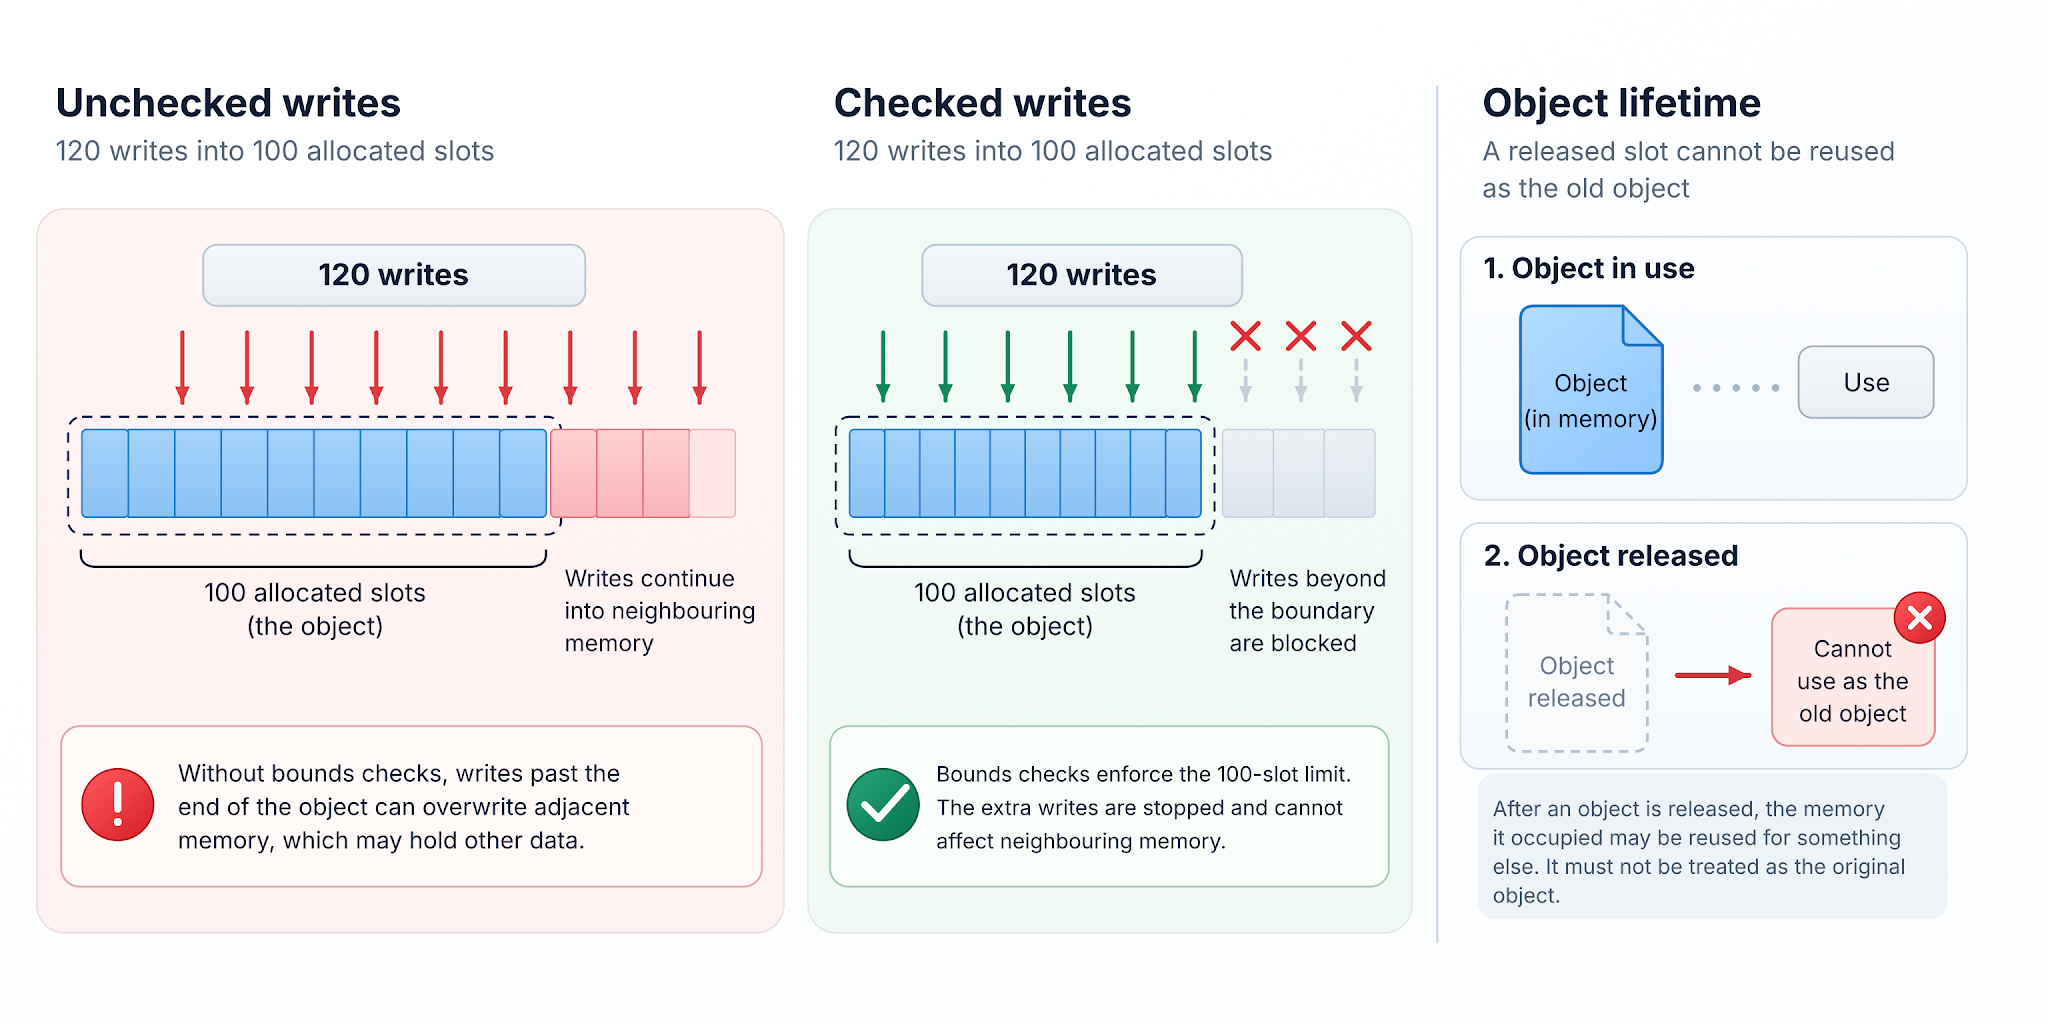
Ein anderer Speicherfehler tritt auf, wenn ein Programm eine Referenz auf ein Objekt behält, nachdem dessen Speicherplatz freigegeben wurde. Wird derselbe Speicherbereich später für ein anderes Objekt wiederverwendet, kann die veraltete Referenz fremde Informationen lesen oder überschreiben. Dies ist ein Use-After-Free-Fehler. Eine reine Bereichsprüfung reicht nicht aus, um den Zugriff gültig zu machen: Die Adresse mag zwar innerhalb eines zugewiesenen Speicherbereichs liegen, aber das Objekt, das die Referenz ursprünglich sinnvoll machte, existiert nicht mehr. Speicherbereichs- und Lebensdauerschutzmechanismen beheben andere Fehler.
Ältere, weit verbreitete Systemprogrammiersprachen wie C und C++ erlauben Formen der direkten Speichermanipulation, für die der Programmierer die notwendigen Grenzen und Lebensdauerregeln festlegen muss. Diese Kontrolle hat wichtige Software ermöglicht, doch Fehler auf unsicheren Pfaden können schwerwiegend und schwer zu erkennen sein. Sorgfältige Implementierung, Code-Reviews, automatisierte Analyse, schützende Compileroptionen und Tests reduzieren das Risiko; sie machen jedoch nicht per Definition jede mögliche Ausführung sicher. Auch das Vorhandensein von C oder C++ in einem Produkt beweist nicht zwangsläufig dessen Anfälligkeit. Entscheidend sind vielmehr die Fragen, welcher Code die relevanten Eingaben verarbeitet, welche Prüfungen und Schutzmechanismen er einsetzt und welche Möglichkeiten dieser Code im Fehlerfall hat.
Speichersichere Sprachmechanismen verlagern einen Teil der Verantwortung auf Regeln, die von der Sprache oder ihrer Laufzeitumgebung durchgesetzt werden. Sicheres Rust weist viele ungültige Referenzen zurück, bevor ein Programm ausgeführt wird, und überprüft indizierte Zugriffe bei Bedarf. Standardmäßige Sicherheitsmechanismen in Swift erzwingen Grenzen und Lebensdauerbeschränkungen. Python-Anwendungscode arbeitet typischerweise mit verwalteten Objekten, anstatt direkte Zeigerarithmetik durchzuführen. Diese Sprachen beseitigen jedoch nicht die Notwendigkeit korrekter Sicherheitsentscheidungen, und ihr Schutz erstreckt sich nicht unbedingt auf jede native Komponente. Rust verfügt über explizit unsichere Bereiche; Swift kann C-Bibliotheken aufrufen oder unsichere Zeiger verwenden; Python kann native Erweiterungen laden. Eine speichersichere Anwendung, die Daten an speicherunsicheren Code übergibt, muss diese Grenze und den dahinterliegenden Code untersuchen. Die Sprachwahl beeinflusst wichtige Risikoklassen, aber ein Produkt muss anhand der tatsächlich ausgeführten Operationen beurteilt werden. [17] [18] [19]
Szekeres, Payer, Wei und Song untersuchten in ihrer 2013 veröffentlichten Arbeit (SoK), wie sich Speicherfehler-Exploits entwickeln und welche verschiedenen Schutzmechanismen dagegen wirken. Ihre Analyse unterscheidet zwischen der Verhinderung ungültiger Speicheroperationen, der Erkennung von Speicherfehlern und der Erschwerung der Ausnutzung nach dem Auftreten eines Fehlers. Dies sind wesentlich unterschiedliche Garantien. Die Arbeit entstand vor der Entwicklung neuerer Compiler- und Hardware-Schutzmechanismen, aber ihre Klassifizierung erklärt, warum das Blockieren einer Exploit-Technik nicht beweist, dass der zugrunde liegende Speicherfehler behoben wurde. [20]
Sicherere Programmiersprachen sind hilfreich, aber bestehende Systeme lassen sich nicht einfach über Nacht ersetzen. C und C++ sind tief in Betriebssysteme, Firmware und Spezialbibliotheken eingebettet, von denen viele an Leistungs-, Hardware- oder Kompatibilitätsgrenzen stoßen. Eine Neuentwicklung kann eigene Fehler mit sich bringen, und Teams benötigen die Kompetenzen und Werkzeuge, um Alternativen zu validieren. Dies rechtfertigt jedoch nicht, unsichere Speicherverwaltung dauerhaft zu akzeptieren. Die praktische Bewertung besteht darin, zu ermitteln, wo nicht vertrauenswürdige Daten unkontrollierte Operationen erreichen, welche nativen Abhängigkeiten bestehen bleiben, welche Berechtigungen diese Komponenten haben und wie Tests, Risikominderungsmaßnahmen und Wartung das Risiko minimieren. Eine Sprachbezeichnung allein kann diese Fragen nicht beantworten. [2]
Wenn das Design selbst angreifbar ist
Design-Schwachstellen können genauso schwerwiegend sein wie Fehler in der Speicherverwaltung oder der Sandbox-Implementierung. Sie entstehen, wenn die vorgesehenen Systemregeln oder Arbeitsabläufe ein schädliches Ergebnis zulassen, obwohl die Software diese Regeln korrekt befolgt. Speichersicherer Code, sorgfältig beschränkte Komponenten und starke Verschlüsselung können ein Design, das Unbefugten Zugriff auf geschützte Vorgänge ermöglicht, nicht kompensieren.
Stellen Sie sich einen fiktiven verschlüsselten Backup-Dienst vor. Dessen Wiederherstellungsfunktion erfordert zwar eine Anmeldung, liefert aber anschließend den Wiederherstellungsschlüssel für jede beliebige Backup-Kennung, ohne zu prüfen, ob das Backup dem jeweiligen Benutzer gehört. Ein Angreifer mit einem normalen Benutzerkonto, der die Kennung eines anderen Kunden kennt, kann dessen Schlüssel erlangen. Die Verschlüsselung wird nicht geknackt, der Speicher nicht beschädigt und die Sandbox nicht verlassen. Das System gibt das Geheimnis preis, weil die notwendige Autorisierungsprüfung im Design nicht vorgesehen war.
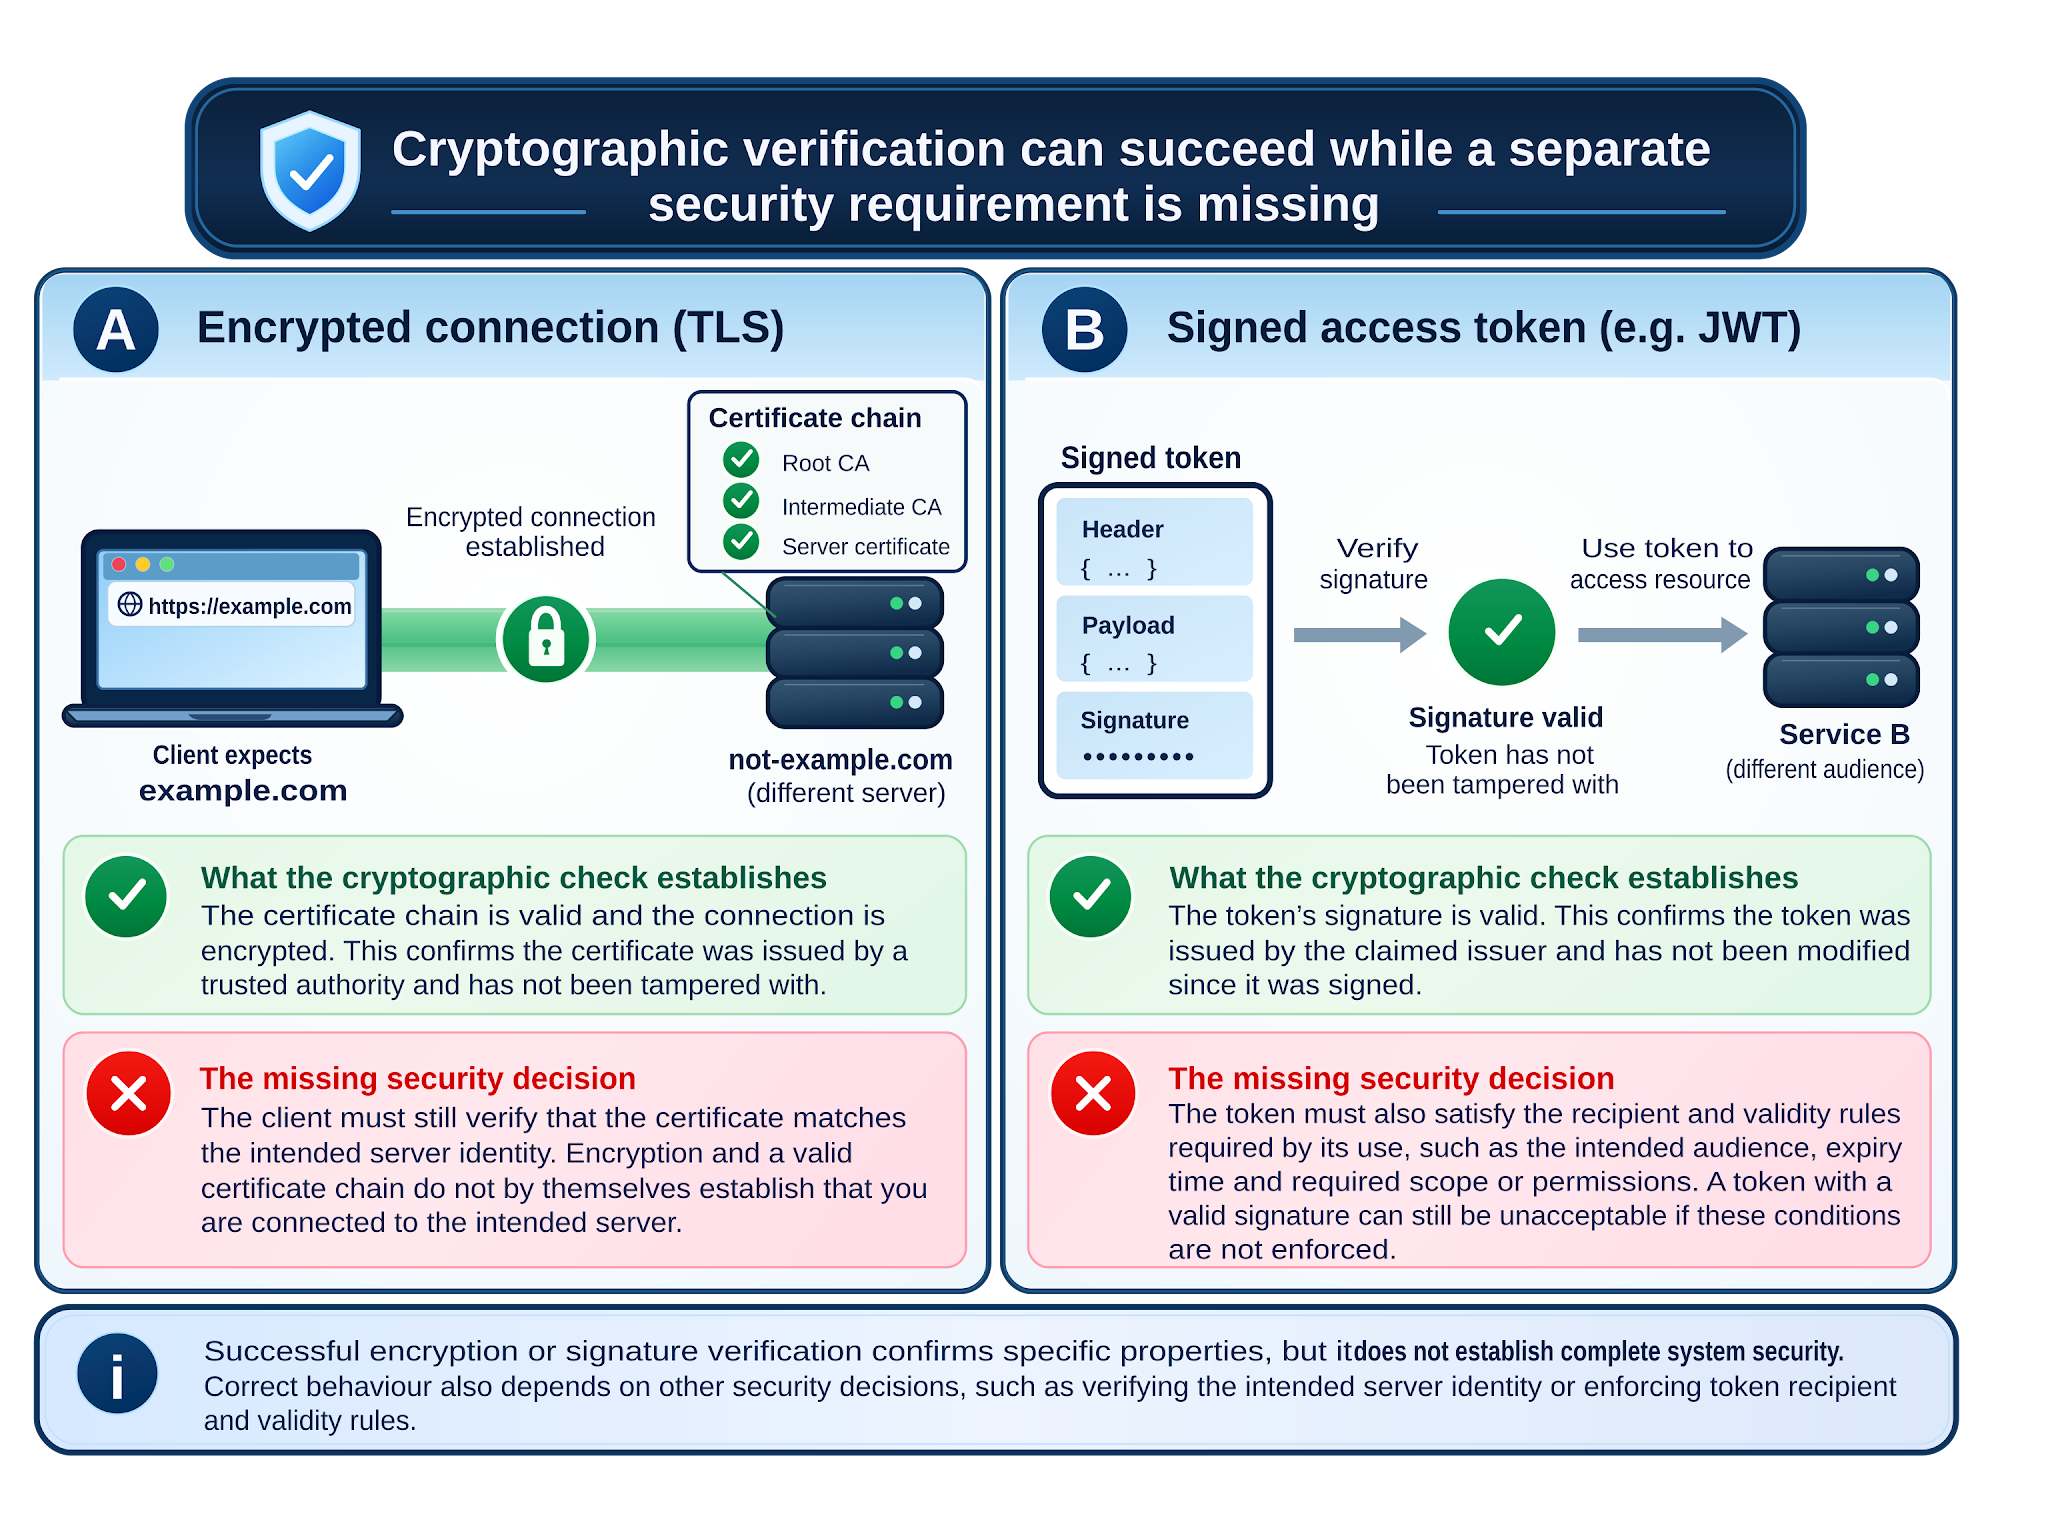
Kryptographie bietet ein weiteres Beispiel für eine korrekte Schutzmaßnahme bei unvollständiger Sicherheitsentscheidung. Verschlüsselung kann Informationen schützen, die zwischen Computern übertragen werden, ohne festzustellen, welcher Dienst sich am anderen Ende befindet oder ob eine Anfrage angenommen werden soll. Dafür sind separate Prüfungen erforderlich. Ein Protokoll legt die Nachrichten und Prüfungen fest, die von kommunizierenden Systemen erwartet werden; die Implementierung ist die Software, die diese Regeln befolgt. Eine Implementierung kann eine erforderliche Prüfung auslassen, während ein Protokoll selbst eine notwendige Anforderung auslassen kann. Die korrekte Funktion einer Schutzmaßnahme gewährleistet daher nicht die Sicherheit des gesamten Vorgangs. [21]
Stellen Sie sich ein Programm vor, das eine Verbindung zu einer Website herstellt. Es baut möglicherweise eine verschlüsselte Verbindung auf und akzeptiert ein Zertifikat eines vertrauenswürdigen Ausstellers, ohne zu prüfen, ob dieses Zertifikat die beabsichtigte Website identifiziert. Die Verschlüsselung funktioniert, aber das Programm kommuniziert möglicherweise mit einem Betrüger. Ein ähnlicher Fehler tritt bei signierten Zugriffstoken auf, digitalen Anmeldeinformationen, die manche Dienste verwenden, um über die Annahme von Anfragen zu entscheiden. Ein Programm überprüft möglicherweise die Signatur des Tokens, aber nicht, ob es von einem akzeptierten Aussteller stammt, für diesen Dienst bestimmt ist oder noch gültig ist. In beiden Fällen führt eine korrekte Prüfung dazu, dass eine andere notwendige Entscheidung ungeklärt bleibt. Keiner der Fehler erfordert eine fehlerhafte Verschlüsselung oder eine gefälschte Signatur. Ross Andersons Buch „Why Cryptosystems Fail“ untersucht die umfassendere Diskrepanz zwischen kryptografischen Schutzmechanismen und dem Versagen realer Systeme. [22] [23] [24]
Clark und van Oorschot untersuchten in ihrer 2013 veröffentlichten Studie „SoK of SSL and HTTPS“, wie Zertifikatsausstellung, Browser-Vertrauensentscheidungen und Infrastrukturpraktiken die Sicherheit verschlüsselter Verbindungen beeinflussen. Ihre Studie ordnete Identitäts- und Zertifikatsvertrauen in das Gesamtsystem ein, anstatt Verschlüsselung als allein ausreichend zu betrachten. Sie analysierte die Mechanismen ihrer Zeit, nicht die heutigen TLS-Implementierungen oder später eingeführte Schutzmechanismen; aktuelle Implementierungen müssen anhand aktueller Standards evaluiert werden. [25]
Geheimnisse können auch durch Verhaltensweisen preisgegeben werden, die nie als Antwort gedacht waren. Unterschiedliche Fehlermeldungen können beispielsweise Aufschluss darüber geben, ob ein Konto existiert. Eine Prüfung, deren Dauer vom jeweiligen Geheimnis abhängt, kann – sofern diese Differenz zuverlässig beobachtet werden kann – über einen Timing-Seitenkanal Informationen preisgeben. Solche Schwachstellen können ohne direkte Anfrage nach dem Geheimnis oder einen gebrochenen Verschlüsselungsalgorithmus auftreten. Nicht jede messbare Differenz ist ausnutzbar; das Signal, die Bedingungen und die daraus ableitbaren Schlussfolgerungen sind entscheidend. [26]
Sicherheit unterscheidet sich von der üblichen Fehlerbehandlung, da ein Angreifer absichtlich Bedingungen erzeugen kann, die ein Entwickler für unwahrscheinlich hielt. Eine fehlerhafte Eingabe, eine ungewöhnliche Abfolge von Anfragen oder eine kompromittierte Abhängigkeit können wiederholt ausprobiert werden, bis ein Weg zum gewünschten Ergebnis führt. Routinemäßige Tests zeigen das Verhalten bekannter Fälle; sie gewährleisten jedoch nicht, dass alle schädlichen Kombinationen ausgeschlossen wurden. Die Frage ist, welche Schutzmechanismen wirksam bleiben, wenn eine Annahme nicht zutrifft.
Eine Designschwäche kann auch in ein Protokoll eingebaut sein: Eine Implementierung kann ihre Regeln genau befolgen, selbst wenn diese Regeln Möglichkeiten bieten, eine ansonsten gültige Nachricht erneut abzuspielen, umzuleiten oder zu missbrauchen. Ross Anderson und Roger Needham untersuchten diese angreifbare Perspektive in ihrem Buch „Programming Satan’s Computer“ [27]. Selbst korrekt spezifizierte und implementierte Software ist darauf angewiesen, dass die Hardware die erwarteten Grenzen einhält.
Wenn die Hardware selbst anfällig ist
Software ist darauf angewiesen, dass Hardware grundlegende Sicherheitsbeschränkungen durchsetzt. Ein Programm sollte nicht in der Lage sein, den geschützten Speicher eines anderen Programms zu verändern, vom Prozessor beschränkte Informationen sollten unzugänglich bleiben, und ein Gerät sollte in einem vertrauenswürdigen Zustand starten. Prozessoren, Speicherchips und der Low-Level-Code, der ein Gerät startet, sind jedoch selbst komplexe Systeme. Ihr Verhalten kann eine Sicherheitsregel untergraben, selbst wenn die darüber liegende Anwendung korrekt programmiert ist.
⚠️ Rowhammer offenbart eine unerwartete physikalische Schwäche. Bei manchen Speicherchips kann der wiederholte Zugriff auf bestimmte Speicheradressen benachbarte Zellen elektrisch stören, bis sich die gespeicherten Bits ändern. Die Software hat diese Änderungen nicht angefordert. Forscher haben gezeigt, dass dieser Effekt auf anfälligen Systemen und unter bestimmten Bedingungen ausgenutzt werden kann, um Speicherschutzmechanismen zu umgehen und höhere Berechtigungen zu erlangen. Ein Programm mag zwar die Regeln für Schreibzugriffe einhalten, doch der physische Speicher kann Informationen außerhalb dieser Grenzen verändern. Rowhammer betrifft nicht alle Speicherdesigns gleichermaßen, und seine praktische Ausnutzbarkeit sowie Gegenmaßnahmen hängen von der Hardware und dem System ab. [28] [29]
⚠️ Andere Hardware-Schwachstellen können Informationen preisgeben, ohne sie zu verändern. Moderne Prozessoren führen mitunter Berechnungen im Voraus durch, indem sie voraussagen, welche Befehle benötigt werden, um Zeit zu sparen. Dies wird als spekulative Ausführung bezeichnet. Sollte sich die Vorhersage als falsch erweisen, wird das vorläufige Ergebnis verworfen. Spuren dieser Berechnungen können jedoch im Cache, einem kleinen Speicher, der dem Prozessor hilft, kürzlich verwendete Informationen schnell abzurufen, erhalten bleiben. Die Analyse dieser Spuren kann mitunter Geheimnisse aufdecken, auf die das Programm keinen Zugriff hatte. Spectre nutzt manipulierte Vorhersagen aus, um solche Offenlegungen zu erzwingen; Meltdown nutzte eine andere Schwachstelle in der Art und Weise, wie einige Prozessoren geschützte Daten verarbeiteten, bevor ein Zugriffsverstoß wirksam wurde. Dies sind sogenannte Prozessor-Seitenkanäle, die mit den zuvor beschriebenen Timing-Lecks zusammenhängen. Sie betreffen die interne Ausführung von Befehlen durch einen Prozessor und nicht nur den veröffentlichten Befehlssatz, der beschreibt, welche Operationen die Software anfordern kann. Die betroffenen Prozessoren, Bedingungen und Gegenmaßnahmen unterscheiden sich. [30] [31] [32]
Die Sicherheit kann auch vor dem Start eines Betriebssystems versagen. Secure Boot etabliert eine Vertrauenskette, indem es vor der Ausführung der einzelnen Startphasen deren Autorisierung überprüft. Einige Geräte speichern den ersten Bootcode im Festwertspeicher (ROM), der nach der Herstellung in der Regel nicht überschrieben werden kann. Dies erschwert zwar spätere Manipulationen, bedeutet aber auch, dass ein Fehler in der ursprünglichen Verifizierungs- oder Wiederherstellungsroutine im ROM möglicherweise nicht behoben werden kann.
⚠️ Die 2018 unter dem Namen Fusée Gelée bekannt gewordene Schwachstelle im Wiederherstellungsmodus des Tegra X1 verdeutlicht einen Fehler, der über physischen USB-Zugriff und nicht über einen Netzwerkdienst ausgenutzt werden kann. Softwareänderungen und betriebliche Einschränkungen können das Risiko zwar verringern, aber sie können den unveränderlichen Boot-ROM nicht überschreiben. Secure Boot bleibt im Rahmen der Garantien seiner Vertrauensanker und der abgedeckten Angriffsszenarien wertvoll. [33] [34] [35]
⚠️ Glosner und Machiry untersuchten in ihrem SoK 2026 43 Bootloader in der Software-Bootkette nach der hardwareseitigen Übergabe. Der zugehörige BOOTBENCH-Datensatz erfasst 3.658 gemeldete Schwachstellen und die damit verbundenen Änderungen. Die Autoren identifizierten zudem Einschränkungen bestehender Erkennungs- und Härtungstechniken. Diese Zahlen belegen jedoch nicht, dass jeder Bootloader angreifbar oder ein bestimmtes Gerät anfällig ist. Sie zeigen vielmehr, warum die Überprüfung der Herkunft der Boot-Software aus einer autorisierten Quelle etwas anderes ist als der Nachweis, dass die autorisierte Implementierung keine ausnutzbaren Fehler aufweist. [36]
Hardware verdeutlicht die Grenzen einschichtiger Sicherheitsvorkehrungen. Die Anwendungssicherheit hängt unter anderem von der Speicherverwaltung des Prozessors, seiner Boot-Kette und der Implementierung der beworbenen Hardware-Schutzmechanismen ab. Diese Abhängigkeiten machen Hardware-Schutzmaßnahmen nicht überflüssig; sie definieren vielmehr die Bedingungen, unter denen Software sich darauf verlassen kann.
Eindämmung eines Fehlers, bevor er sich ausbreitet
Sicherheitstechnik begrenzt auch die Folgen eines nicht verhinderten Fehlers. Ein Programm, das ein unbekanntes Dateiformat verarbeitet, sollte nicht automatisch denselben Zugriff auf vertrauliche Datensätze, Netzwerkdienste und leistungsstarke Operationen erhalten wie die aufrufende Anwendung. Betriebssysteme können die Grenzen zwischen laufenden Prozessen festlegen und deren Berechtigungen einschränken. Eine Sandbox ist eine Reihe solcher erzwungener Beschränkungen. Die entscheidende Frage ist, welche laufende Komponente von welchen Ressourcen ausgeschlossen ist. Das Speichern von Dateien in separaten Quellordnern, der Aufruf einer Funktion über eine andere Programmiersprache oder die Beschreibung einer Bibliothek als isoliert schaffen allein keine Betriebssystemgrenze. [10]
Ein in die Hauptanwendung geladener nativer Decoder teilt sich üblicherweise den Prozess, den Speicher und einen Großteil der Berechtigungen dieser Anwendung. Durch die Auslagerung der Dekodierung in einen separaten Prozess erhält der Worker einen eigenen Adressraum. Zusätzliche, angemessen enge Beschränkungen für diesen Worker können die direkten Auswirkungen eines Fehlers oder einer Kompromittierung reduzieren. Beide Versionen können sich innerhalb derselben äußeren Anwendungssandbox befinden; der zusätzliche Schutz ergibt sich aus den eigenen Grenzen und Berechtigungen des Workers. Diese Vorgehensweise verursacht Kosten für Kommunikation, Timeouts und Wiederherstellung, und der Host muss die Ergebnisse des Workers weiterhin überprüfen. Ein eingeschränkter Worker, der beliebige privilegierte Dateizugriffe vom Host anfordern kann, kann das Confused-Deputy-Problem über die Prozessgrenze hinweg einfach reproduzieren.
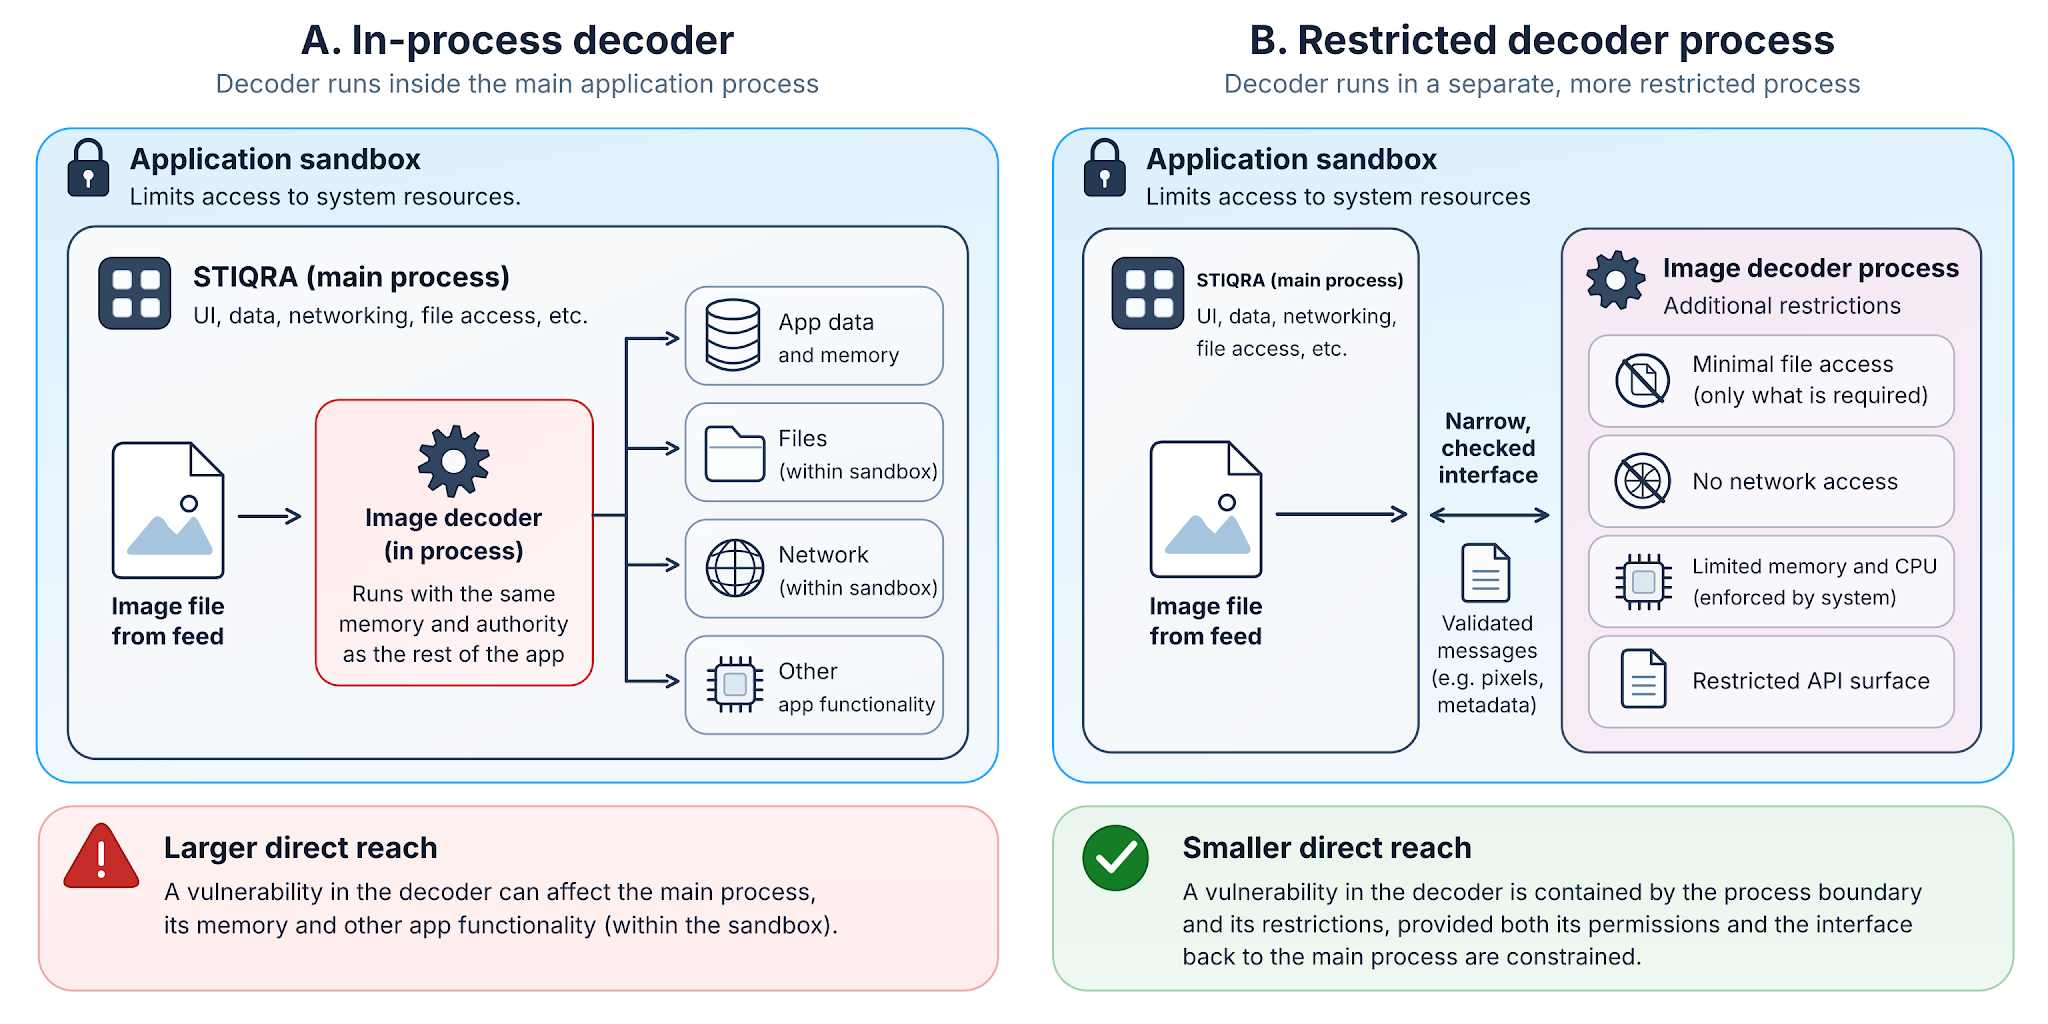
Es gibt umfangreiche Forschung darüber, wie diese Abgrenzungen in der Praxis funktionieren oder scheitern. Lefeuvre und Kollegen analysierten in ihrem SoK 2025 211 Forschungsarbeiten und 61 gängige, segmentierte Systeme. Sie identifizierten anhaltende Schwierigkeiten bei der Definition praktikabler Isolationsrichtlinien, der Übertragung von Forschungsergebnissen in die Produktion und der Bewertung von Bedrohungen durch Confused-Deputy-Probleme und Hardwarebeschränkungen. Ein separater Prozess ist kein Beweis für effektive Eindämmung, wenn seine Berechtigungen zu hoch sind oder ein privilegierter Host uneingeschränkte Anfragen von ihm bearbeitet. Die relevante technische Aufgabe besteht darin, die auf beiden Seiten einer Schnittstelle verfügbaren Berechtigungen zu definieren und nachzuweisen, dass die durchgesetzten Abgrenzungen diesem Entwurf entsprechen. [37]
Containment verdeutlicht ein allgemeines Prinzip: Prävention und Schadensbegrenzung haben unterschiedliche Aufgaben. Eingabeprüfungen zielen darauf ab, schädliche Operationen im Vorfeld zu verhindern. Speichersicherheitsregeln unterbinden bestimmte ungültige Zugriffe. Sandboxing beschränkt die Ressourcen, auf die fehlerhafter Code zugreifen kann. Überwachung und Wiederherstellung helfen einem Dienst, verbleibende Fehler zu erkennen und darauf zu reagieren. Verschiedene Schutzmechanismen können die Folgen eines Fehlers reduzieren, ihre Unabhängigkeit muss jedoch nachgewiesen und darf nicht vorausgesetzt werden. Ein erfolgreich ausgenutzter Fehler kann daher auf eine eingeschränkte Komponente beschränkt bleiben; er gewährt nicht automatisch Zugriff auf alle Teile des Systems. Eine ehrliche Sicherheitsaussage benennt die verbotene Auswirkung und die Mechanismen, die die relevanten Grenzen durchsetzen, anstatt Technologien aufzuzählen oder mit dem Begriff „sicher“ zu werben. [38]
⚠️ Die Grenzen der Eindämmung und des Hardwareschutzes
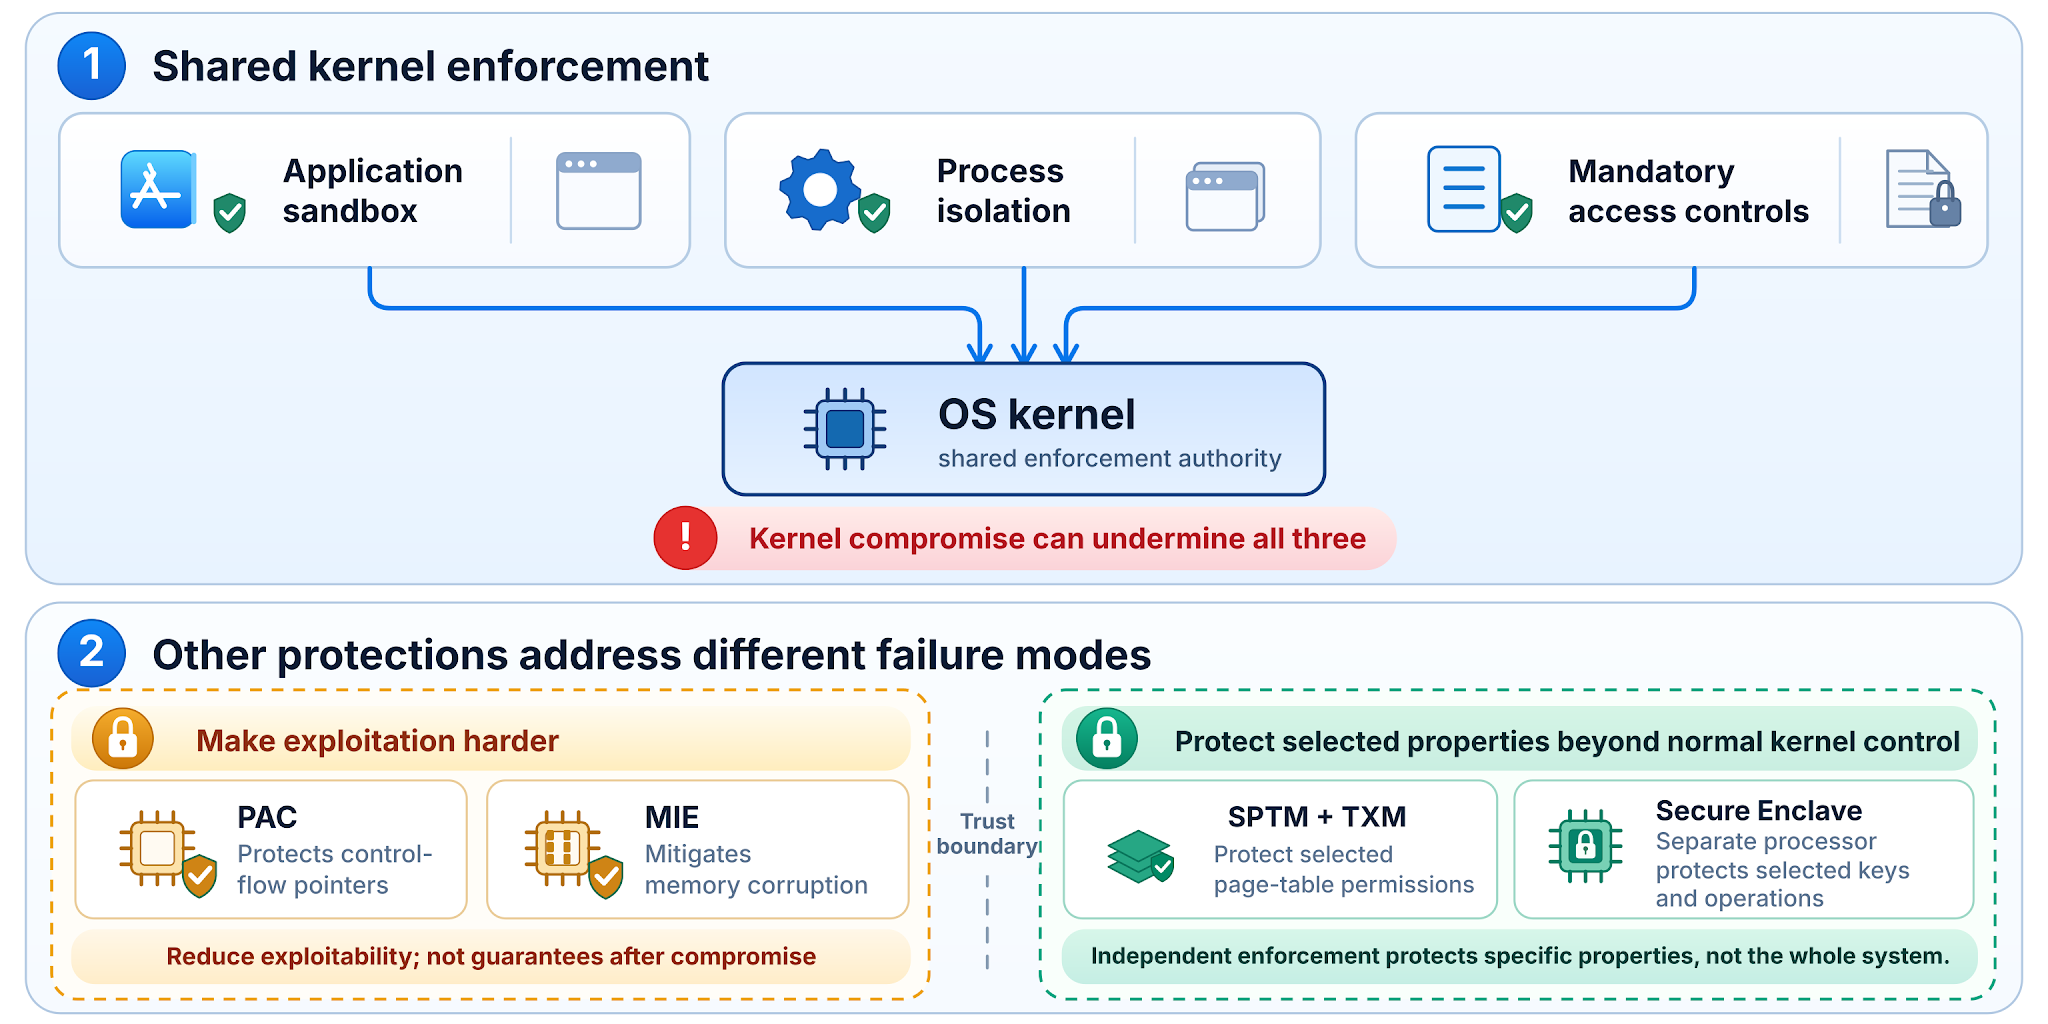
Manche Schutzmechanismen erscheinen unabhängig, weil sie unterschiedliche Namen und Einstellungen haben, aber auf derselben Instanz basieren. Anwendungssandboxes, Prozessisolation und obligatorische Zugriffskontrollen nutzen üblicherweise den Betriebssystemkernel, um ihre Beschränkungen durchzusetzen. Der Kernel ist die zentrale Komponente, die Programme, Speicher und Berechtigungen verwaltet. Erlangt ein Angreifer ausreichende Kontrolle über den Kernel, kann er die Regeln, auf denen diese Schutzmechanismen beruhen, ändern oder ignorieren. Mehrere Schutzebenen stellen nicht zwangsläufig mehrere unabhängige Verteidigungslinien dar. [39]
Hardwaregestützte Schutzmaßnahmen können die Kompromittierung des Kernels erschweren. Die Zeigerauthentifizierung (PAC) signiert und authentifiziert ausgewählte Zeiger und vereitelt so einige Kontrollflussangriffe, die auf deren Beschädigung basieren. Auf Apple-Systemen mit Memory Integrity Enforcement (MIE) verhindern Hardware-Speicherkennzeichnung, typisierte Speicherzuweisung und zugehörige Betriebssystembeschränkungen bestimmte Arten der Ausnutzung von Speicherbeschädigungen, einschließlich Angriffe auf geschützten Systemcode. Keiner der beiden Mechanismen stellt eine unabhängige Instanz dar, die die Sandbox-Richtlinien von Anwendungen aufrechterhalten kann, sobald ein Angreifer ausreichende Kontrolle über den Kernel erlangt hat. [40]
Einige Schutzmechanismen arbeiten außerhalb der üblichen Kontrolle des Kernels. Auf unterstützten Apple-Systemen beschränkt der Secure Page Table Monitor (SPTM) in Zusammenarbeit mit einem Trusted Execution Monitor bestimmte Änderungen an der Seitentabelle, selbst wenn ein Angreifer Schreibrechte am Kernel erlangt hat. Es handelt sich dabei um eng gefasste, hardwareseitig unterstützte Speicher- und Codeintegritätsbeschränkungen, nicht um ein fortwährendes Vertrauen in die Entscheidungen des Kernels bezüglich Benutzern, Dateien oder Netzwerkzugriffen. Welche Eigenschaften erhalten bleiben, hängt von der Plattform und den Fähigkeiten des Angreifers ab. [39]
Die Secure Enclave ist ein Beispiel für eine separate Sicherheitsbarriere. Auf unterstützten Apple-Geräten handelt es sich um einen Sicherheitsprozessor mit eigenem sicheren Startvorgang, geschütztem Speicher und Mikrokernel. Sie ist so konzipiert, dass ausgewählte Geheimnisse selbst dann geschützt werden, wenn der Hauptkernel des Betriebssystems kompromittiert ist. Eine Anwendung kann einen privaten Schlüssel für Operationen generieren, die von der Secure Enclave ausgeführt werden, und zulässige kryptografische Operationen anfordern, ohne den Schlüssel selbst zu erhalten. Was geschützt bleibt, hängt von der Zugriffsrichtlinie des Schlüssels und den von der Enclave überwachten Operationen ab, nicht allein vom Vorhandensein des Chips. [41] [42]
Andere Systeme nutzen andere, hardwareseitig erzwungene Sicherheitsgrenzen. Ein Trusted Platform Module (TPM), das als separates Gerät oder im Prozessor implementiert ist, schützt ausgewählte kryptografische Schlüssel und kann deren Verwendung an Messungen des Systemstarts binden; es ist keine universelle Umgebung für die Ausführung von Anwendungscode. Arm TrustZone trennt sichere und normale Ausführungszustände auf unterstützten Prozessoren, sodass bestimmte Software und Ressourcen für das normale Betriebssystem unzugänglich bleiben können, sofern das System korrekt konzipiert ist. Intel Software Guard Extensions (SGX) isolieren auf unterstützten Prozessoren ausgewählten Anwendungscode und Daten in Enklaven von privilegierter Software, einschließlich des Betriebssystemkerns. Im Gegensatz zu Apples Secure Enclave benötigen TrustZone und SGX keinen separaten Sicherheitsprozessor. Sie schützen zudem unterschiedliche Ressourcen und sind nicht austauschbar. [43] [44] [45]
Die Aufrechterhaltung einer vom Hauptkernel unabhängigen Sicherheitsinstanz kann nach einer Kernel-Kompromittierung dazu beitragen, das Vertrauen in die Plattform wiederherzustellen. Ein vertrauenswürdiger Start- oder Wiederherstellungspfad, der außerhalb der Kontrolle des Kernels verankert ist, kann autorisierte Firmware und Betriebssystemsoftware überprüfen, bevor das Gerät wieder in Betrieb genommen wird. Geschützte Schlüssel und Messungen des Bootvorgangs können diese Prüfungen unterstützen. Das NIST unterscheidet Vertrauensanker für die Erkennung unautorisierter Änderungen, die Genehmigung von Updates und die Wiederherstellung beschädigter Plattform-Firmware. Diese Elemente müssen zu einem funktionierenden Wiederherstellungsprozess zusammengeführt werden: Ein TPM, eine Secure Enclave, eine TrustZone-Umgebung oder eine SGX-Enklave allein kann ein kompromittiertes Betriebssystem nicht wiederherstellen. [35] [38]
Eine solche Wiederherstellung ist nur innerhalb eines definierten Bedrohungsmodells möglich. Die Wiederherstellungs-Firmware, die Hardware-Vertrauensankerstelle und die Quelle der Ersatzsoftware müssen selbst vertrauenswürdig bleiben. Solange der kompromittierte Kernel nicht ersetzt ist, kann ein Angreifer weiterhin Anfragen an geschützte Komponenten manipulieren, den Dienst verweigern oder Informationen vor oder nach dem Schutz ausspionieren, selbst wenn einige Schlüssel oder der Enklavenspeicher unzugänglich bleiben. Bereits offengelegte Informationen können nicht rückgängig gemacht werden. Der Unterschied liegt darin, einen ausgewählten Zustand während einer Kompromittierung zu schützen und anschließend einen vertrauenswürdigen Betrieb wiederherzustellen.
Zinkus, Jois und Green untersuchten in ihrem SoK 2022 die Vertraulichkeit von Daten auf Mobilgeräten gegenüber leistungsstarken Angreifern, die Daten extrahieren können, darunter solche mit physischem Gerätezugriff oder Zugriff auf zugehörige Cloud-Dienste. Ihr Fokus geht über den Schutz eines Schlüssels hinaus: Informationen können auch vor ihrer Sicherung, nach der Entschlüsselung oder durch abhängige Dienste offengelegt werden. Diese historische Analyse bestätigt nicht das aktuelle Verhalten von SPTM oder Secure Enclave. Sie unterstreicht vielmehr die Notwendigkeit, festzulegen, welche Informationen vor welchen Angriffen geschützt bleiben und wo sie die Vertrauensgrenze verlassen. [46]
Die Grenzen kernelabhängiger Schutzmechanismen
| Mechanismus | Was es tatsächlich schützt | Nach einer Kompromittierung des Hauptkernels |
|---|---|---|
| Sandbox, Prozessisolation und MAC | Der Kernel setzt diese Grenzen durch; ein Angreifer, der ihn kontrolliert, kann sie umgehen. | ✕ Nicht zuverlässig |
| Zeigerauthentifizierung (PAC) | Erschwert bestimmte Angriffe, die manipulierte Zeiger ausnutzen; es setzt die Kernel-Richtlinien nach der Übernahme nicht durch. | ✕ Nicht unabhängig |
| Speicherintegritätssicherung (MIE) | Es prüft geschützte Speicherzugriffe; es kann einen kompromittierten Kernel nicht vertrauenswürdig machen. | ✕ Keine allgemeine Garantie |
| Secure Page Table Monitor (SPTM) | Mit TXM werden ausgewählte Seitentabellenbeschränkungen außerhalb der normalen Kontrolle des Kernels durchgesetzt. | ⚠ Ausgewählte Einschränkungen |
| Secure Enclave | Ein separater Sicherheitsprozessor und sein Mikrokernel schützen ausgewählte Schlüssel und Operationen. | ✓ Innerhalb seiner Grenzen |
SPTM kann nach einer Kompromittierung des Kernels bestimmte Speicherbeschränkungen aufrechterhalten, und die Secure Enclave kann bestimmte Schlüssel schützen. Keines von beiden stellt jedoch allein das Vertrauen in das Betriebssystem wieder her.
Ein iPhone unterstützt zwar MIE und PAC, das bedeutet aber nicht, dass jede darauf laufende App beide Schutzmechanismen nutzt. Apple implementiert MIE automatisch auf ausgewählten Angriffsflächen des Systems, einschließlich des Kernels. Dieser Schutz erstreckt sich jedoch nicht automatisch auf alle Drittanbieter-Apps, Erweiterungen, Hilfsprozesse oder Bibliotheken. Zwei Apps auf demselben unterstützten iPhone können daher unterschiedliche Schutzmechanismen aufweisen. MIE kombiniert von Apple entwickelte Hardware, sichere Speicherverwaltung und Betriebssystemsteuerung; es handelt sich nicht einfach um die allgemeine Arm Memory Tagging Extension (MTE).
Um Hardware-Speicher-Tagging in eigenen Apps zu verwenden, müssen Entwickler es für die entsprechenden Xcode-Ziele aktivieren und die Hardwareunterstützung bestätigen. Berechtigungen und Laufzeiteinstellungen sind ebenfalls wichtig: Ein Diagnosemodus, der simulierte Fehler meldet, ist nicht dasselbe wie die Erzwingung der Prüfungen. PAC ist eine separate Schutzmaßnahme. Kompatible Hardware allein bedeutet nicht, dass jede App-Binärdatei PAC verwendet; der relevante Code muss für die entsprechende arm64e-Architektur kompiliert werden, und externe native Bibliotheken benötigen kompatible Builds. Entwickler sollten überprüfen, welche Schutzmechanismen in der tatsächlichen Version aktiviert sind, einschließlich ihrer Komponenten und Abhängigkeiten, und auf unterstützten physischen Geräten testen. Eine Gerätespezifikation ist kein Beweis dafür, dass die Schutzmechanismen in einer bestimmten App funktionieren. [47] [48] [49]
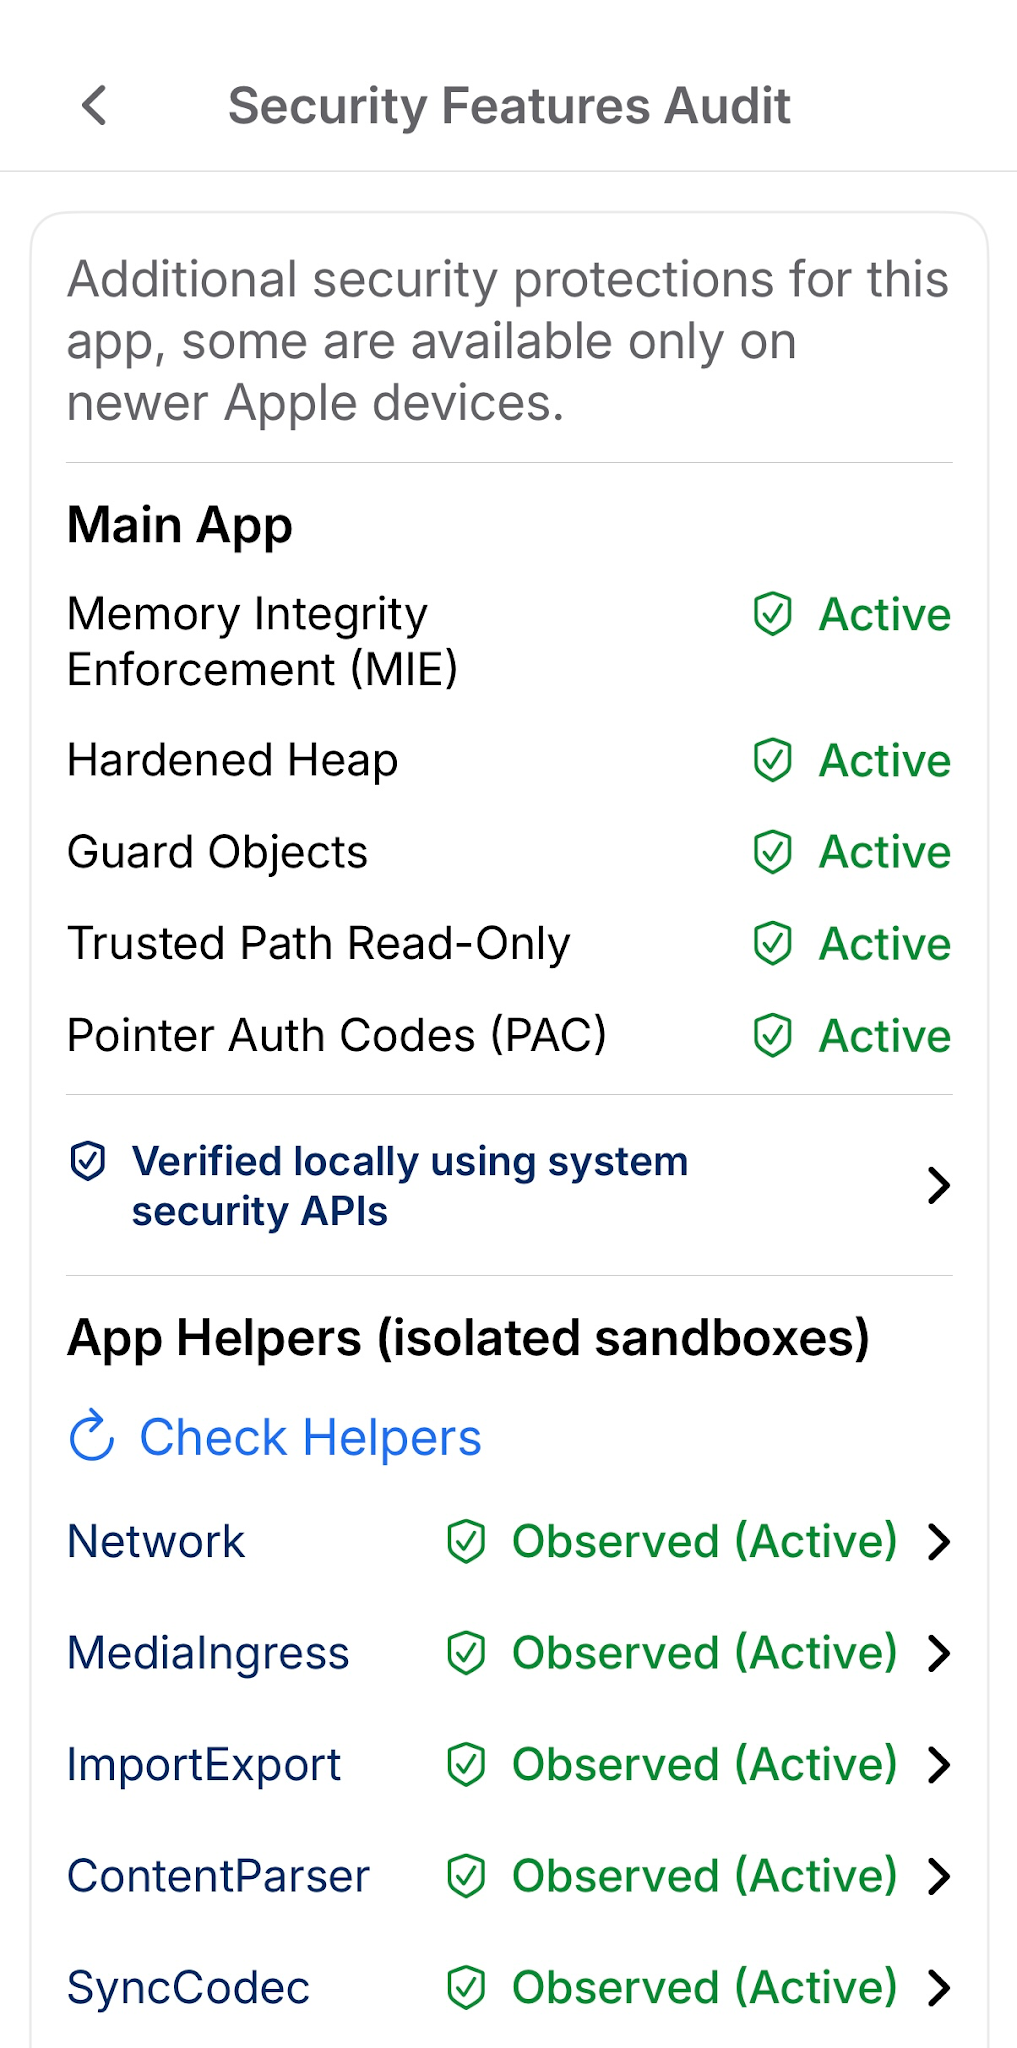
Ein Architekturdiagramm oder eine Funktionsliste kann nicht belegen, welche Schutzmechanismen im veröffentlichten Produkt wirksam sind. Entscheidend ist vielmehr, welche Prozesse tatsächlich geschützt sind, welche Instanz die einzelnen Beschränkungen durchsetzt und was unter den betrachteten Fehlerbedingungen weiterhin geschützt bleibt.
Wenn die Schutzmechanismen versagen
Sicherheitsbeschränkungen müssen auch dann gelten, wenn eine erforderliche Prüfung oder ein Vorgang fehlschlägt. Ist ein Autorisierungsdienst nicht verfügbar, berechtigt das Fehlen einer Entscheidung nicht automatisch zum Fortfahren. Wird eine mehrstufige Änderung abgebrochen, können teilweise aktualisierte Datensätze gegen die Regeln verstoßen, die der Vorgang eigentlich gewährleisten sollte. Die Reaktion muss für die jeweilige Aufgabe definiert sein: eine nicht verifizierte Aktion ablehnen oder verschieben, einen konsistenten Zustand beibehalten und unterbrochene Arbeit wiederherstellbar machen. Einen Fehler als Genehmigung zu behandeln, ist ein Fail-open-Fehler; jeden Fehler als dauerhaften Ausfall zu werten, ist ebenfalls kein angemessenes Design. [50]
Eine Kompromittierung endet nicht zwangsläufig mit dem ersten erreichten Konto oder Prozess. Ein Angreifer kann diesen Zugang nutzen, um höhere Berechtigungen zu erlangen (Privilegienausweitung) oder in weitere Systeme einzudringen (laterale Bewegung). Jeder weitere Schritt hängt von einer ausnutzbaren Schwachstelle, Anmeldeinformationen oder einer vertrauenswürdigen Beziehung ab; die Kontrolle über einen Dienst bedeutet nicht automatisch die Kontrolle über benachbarte Dienste. Daher bestimmen die am ersten Zugangspunkt verfügbaren Berechtigungen, die Trennung zwischen Systemen und die Überprüfung privilegierter Anfragen, wie weit sich ein Angriff ausbreiten kann. Eindämmungsmaßnahmen können den Fortschritt selbst dann noch unterbrechen, wenn die erste Komponente kompromittiert wurde. [51] [52]
Die Wiederherstellung des Betriebs ist entscheidend, wenn Prävention und Eindämmung nicht ausreichen. Ein Angreifer, der administrative Kontrolle erlangt, kann Datensätze verändern, Dateien löschen oder Ransomware einsetzen, die Daten unbrauchbar macht. Ein Backup kann den Schaden durch Zerstörung oder Beschädigung reduzieren, aber bereits gestohlene Informationen nicht wiederherstellen. Auch ein Backup, das unter denselben kompromittierten Berechtigungen gespeichert wurde, kann vom Angreifer verändert oder gelöscht werden. Wiederherstellbare, angemessen geschützte Kopien und Übungen zur Überprüfung der Wiederherstellung sind daher neben Sicherheitspatches unerlässlich. Überwachung kann ungewöhnliche Aktivitäten erkennen und Beweise sichern; Notfallverfahren legen fest, wer betroffene Systeme isolieren, Zugangsdaten entziehen und einen vertrauenswürdigen Dienst wiederherstellen darf. Diese Maßnahmen sind kein Eingeständnis, dass ein sicheres Design versagt hat. Sie erkennen an, dass der Schutz eines Systems auch die Begrenzung des Schadens durch verbleibende Fehler und die Wiederherstellung legitimer Arbeitsabläufe in einen bekannten, fehlerfreien Zustand umfasst. [38]
Wenn die Lieferkette die Sicherheit untergräbt
Selbst kleine Anwendungen sind auf Software angewiesen, die von anderen entwickelt, erstellt und gewartet wird: Betriebssystemkomponenten, Bibliotheken, Entwicklungswerkzeuge und externe Dienste. Ein gemeldeter Fehler ist nur dann relevant, wenn eine betroffene Version vorhanden ist und eine entsprechende Funktion offengelegt wird. Dies festzustellen, kann sich jedoch bei Abhängigkeiten, die zu unterschiedlichen Zeiten gewartet werden, als schwierig erweisen. Ein Produktname sagt daher wenig über die tatsächlich an seinem Betrieb beteiligten Komponenten und Dienste aus. [53]
Ein hilfreicher Vergleich ist die Zutatenliste. Ein Hersteller, der die Inhaltsstoffe eines Produkts nicht identifizieren kann, kann nicht ohne Weiteres feststellen, ob ein neu entdecktes Problem dieses Produkt betrifft. Software stellt dieselbe Schwierigkeit dar. Eine Software-Stückliste (SBOM) erfasst Komponenten und Versionen, um die Transparenz zu verbessern, einschließlich Abhängigkeiten, die durch andere Abhängigkeiten entstehen. Sie hilft einem Unternehmen festzustellen, ob eine gemeldete Sicherheitslücke in einer Bibliothek besteht, ist aber kein Sicherheitszertifikat. Das Inventar kann unvollständig sein, der anfällige Code ist möglicherweise nie erreichbar, oder eine in einer Version fehlende Komponente kann in der nächsten enthalten sein. Ein Inventar wird erst dann nützlich, wenn es gepflegt wird, mit den tatsächlich eingesetzten Komponenten verknüpft ist und ein Prozess zur Bewertung und Behebung betroffener Systeme implementiert ist. [54]
Abu Ishgair und Kollegen nutzen in ihrem 2026 veröffentlichten SoK das AStRA-Modell, um die Akteure, Schritte, Ressourcen und Artefakte zu untersuchen, die an der Softwareentwicklung und -verteilung beteiligt sind. Sie unterscheiden zwischen Fragen, die ein SBOM beantworten kann, und solchen, die Nachweise über Quellcodeänderungen, Build-Integrität, Freigabeberechtigung und Auslieferung erfordern. Ein vollständiges Inventar belegt nicht die Vertrauenswürdigkeit eines Builds, und die Herkunftsnachweise garantieren nicht die Fehlerfreiheit des resultierenden Programms. Die Nachweise müssen dem jeweiligen Lieferkettenrisiko entsprechen, das bewertet wird. [55]
Die Kenntnis der vorhandenen Komponenten garantiert weder deren Vertrauenswürdigkeit noch deren Verbreitung. Ein Angreifer kann schädliches Verhalten in Abhängigkeiten, Quellcode-Repositorys, Build-Prozesse oder Software-Updates einschleusen, sodass Benutzer im Rahmen einer scheinbar legitimen Veröffentlichung schädlichen Code erhalten. Dies stellt eine Kompromittierung der Software-Lieferkette dar und unterscheidet sich von der zufälligen Entdeckung einer Schwachstelle in einer Komponente. Die Überprüfung von Herkunft und Integrität eines Pakets kann helfen, unautorisierte Austauschvorgänge zu erkennen. Doch selbst eine korrekt signierte Version kann schädlich sein, wenn der Lieferant oder dessen Build-Prozess kompromittiert wurde. Der Schutz der Softwarebereitstellung erfordert daher auch Kontrollen darüber, wer Code und Releases ändern darf, wie Build-Zugangsdaten gehandhabt werden und welche Nachweise ein ausgeliefertes Artefakt mit seiner vorgesehenen Quelle verknüpfen. Ein SBOM identifiziert die Bestandteile; es garantiert jedoch nicht die Sicherheit ihrer Inhalte oder ihres Bereitstellungswegs. [53]
Software gelangt nicht direkt vom Editor des Programmierers zum Gerät des Benutzers. Der Code durchläuft verschiedene Stationen: Maintainer, Repositories, Build-Tools, automatisierte Dienste, Signaturschlüssel, Freigabeberechtigte und Vertriebskanäle. Ein Reviewer kann zwar den Quellcode prüfen, aber dennoch eine während der Paketierung eingeführte, böswillige Änderung übersehen; ein streng kontrollierter Build-Prozess bietet wenig Schutz, wenn ein Angreifer die von ihm erstellte Software autorisieren kann. Die Trennung und Überprüfung dieser Verantwortlichkeiten ist wichtig, da eine scheinbar legitime Version in einem für den Endbenutzer unsichtbaren Schritt manipuliert worden sein kann. [56]
Die 2024 entdeckte xz Utils-Backdoor legte dieses Problem mit ungewöhnlicher Deutlichkeit offen. Schadcode wurde in Release-Archiven versteckt und so angeordnet, dass er bestimmte Linux-Paket-Builds beeinträchtigte und potenziell die Remote-Login-Authentifizierung auf Systemen mit bestimmten Abhängigkeiten untergrub. Das verteilte Release-Archiv entsprach nicht einfach dem Quellcode, den ein Prüfer im öffentlichen Repository einsehen konnte: Der Build-Prozess bestimmte, was letztendlich in der Software landete. Der Angriff wurde entdeckt, bevor die betroffenen Versionen in stabilen Linux-Distributionen weit verbreitet waren. Er zeigte jedoch, dass ein scheinbar autorisiertes Upstream-Release absichtlich eingeschleuste Schadfunktionen in Downstream-Pakete einschleusen konnte. Deshalb reicht es nicht aus, einem bekannten Projekt oder seinem offiziellen Downloadpfad zu vertrauen. Es handelte sich um eine Kompromittierung der Lieferkette, nicht um einen versehentlichen Programmierfehler. [57] [58]
Die Herkunftsnachverfolgung versucht, eine ausgelieferte ausführbare Datei mit dem Quellcode, den Werkzeugen, Einstellungen und dem Dienst zu verknüpfen, der sie erzeugt hat. Reproduzierbare Builds können zusätzliche Beweise liefern, wenn unabhängige Parteien mit demselben Quellcode übereinstimmende Ergebnisse erzielen. Frameworks wie SLSA beschreiben Methoden zur Aufzeichnung und Überprüfung dieser Historie. Die Vertrauenswürdigkeit eines Protokolls hängt jedoch von den Systemen ab, die es erzeugen, und den unabhängigen Erwartungen, anhand derer es überprüft wird. Ein kompromittierter Quellcode kann reproduzierbar erstellt werden; ein fehlerhafter Build-Dienst kann falsche Zusicherungen liefern; eine signierte Erklärung, die niemand überprüft, ist wenig hilfreich. Die Herkunftsnachverfolgung kann Teile einer Nachweiskette belegen, aber nicht, ob sich die zugrunde liegende Software sicher verhält. [59] [60]
Die Unterzeichnung und Verteilung von Releases stellen separate Bereiche dar. Eine gültige digitale Signatur kann belegen, dass ein Artefakt mit einem bestimmten Schlüssel signiert wurde und sich seitdem nicht verändert hat. Sie kann jedoch nicht nachweisen, dass der Unterzeichner vertrauenswürdig war, der Schlüssel nicht gestohlen wurde oder das signierte Programm sicher ist. Ein signiertes Release ist ein Nachweis der Autorisierung durch einen Schlüssel, kein Unbedenklichkeitszertifikat. HTTPS schützt die Verbindung zu einer Download-Website; es garantiert jedoch nicht, dass die Website, ihr Herausgeberkonto oder der Download selbst nicht kompromittiert wurden. Eine auf derselben kompromittierten Seite angezeigte Prüfsumme bietet kaum unabhängige Sicherheit. Sichere Update-Systeme überprüfen daher zusätzlich den erwarteten Herausgeber, vertrauenswürdige Metadaten, Versionen und autorisierte Signaturstellen und schützen vor dem Zurücksetzen auf alte, anfällige Releases. Diese Prüfungen reduzieren bestimmte Angriffe, ohne die Notwendigkeit, dem Release-Prozess zu vertrauen und ihn zu schützen, zu beseitigen. [61]
Die Hardware-Lieferkette birgt ein damit zusammenhängendes, schwerer zu überprüfendes Problem. Ein Chip kann als sorgfältig geprüftes Design beginnen, Schaltungen oder Designkomponenten anderer Zulieferer integrieren und die Phasen Fertigung, Test, Verpackung, Transport und Integration durchlaufen. Das theoretische Design mag zwar schlüssig sein, doch das garantiert nicht, dass das an den Kunden gelieferte Silizium diesem entspricht. Ein Angreifer mit Zugriff auf relevante Produktionsstufen könnte prinzipiell Schaltungen verändern, einen versteckten Hardware-Trojaner einschleusen, Komponenten austauschen oder die zugehörige Firmware während der Fertigung oder Auslieferung modifizieren. Dies sind anerkannte Bedrohungen, die bewertet werden müssen, aber kein Beweis dafür, dass ein bestimmter Hersteller oder ein bestimmtes Gerät kompromittiert wurde. [62] [63]
Ein verifizierter Bauplan ist kein verifizierter Chip. Die Überprüfung des Normalbetriebs, das Testen von Mustern, die Prüfung von Produktionsunterlagen, die Zusammenarbeit mit vertrauenswürdigen Lieferanten, die Führung von Nachweisdokumenten und die Authentifizierung von Komponenten können die Hardware-Sicherheit stärken. Seltene oder absichtlich verborgene Schaltungsfunktionen können jedoch Routineprüfungen entgehen, und die Identität oder der Attestierungsmechanismus eines Geräts hängt von Hardware und Schlüsseln ab, deren Ursprung ebenfalls vertrauenswürdig sein muss. Secure Boot kann spätere Software nur insoweit verifizieren, als der hergestellte Ausgangspunkt dieser Verifizierung vertrauenswürdig ist. Kein einzelnes Zertifikat oder keine einzelne Inspektion beweist die Abwesenheit einer böswilligen Modifikation in der gesamten Kette. [62] [63]
Wartung und der Wettlauf um Sicherheitskorrekturen
Updates verdienen besondere Aufmerksamkeit, da sie häufig Fehler beheben, die bereits gut genug bekannt sind, um repariert zu werden. Sobald Details einer Schwachstelle öffentlich werden, suchen Angreifer möglicherweise nach Systemen, auf denen noch die betroffene Version läuft. Manche Sicherheitslücken werden bereits ausgenutzt, bevor ein Fix verfügbar ist. Verzögerte Updates können ein System daher anfällig für Angriffe machen, die keine eigene Recherche seitens des Angreifers mehr erfordern. Der notwendige Aufwand geht über das Klicken eines Update-Buttons hinaus: Eine Organisation muss wissen, welche Computer und Dienste sie besitzt, welche Versionen darauf laufen, ob ein Fix des Herstellers existiert, ob eine betroffene Funktion offengelegt ist und ob die Änderung erfolgreich implementiert wurde. Geräte und Dienste, deren Herstellersupport ausgelaufen ist, stellen ein anderes Problem dar, da möglicherweise keine Sicherheitsupdates mehr bereitgestellt werden. [64]
Die Verantwortung für Updates erstreckt sich über die sichtbare Anwendung hinaus auf Betriebssysteme, Browser, Router, Plug-ins, Serversoftware und Firmware. Endgeräte aktualisieren sich möglicherweise automatisch, doch Unternehmen betreiben auch selten genutzte Rechner, übernommene Dienste und Systeme von Drittanbietern, deren Versionen nicht offensichtlich sind. Diese werden leicht übersehen, gerade weil sie scheinbar funktionieren. Eine genaue Bestandsaufnahme, ein benannter Verantwortlicher und der Nachweis, dass ein Update das laufende System erreicht hat, unterscheiden einen Patch-Prozess von einer Liste veröffentlichter Korrekturen.
Das Melden einer Sicherheitslücke ist nicht dasselbe wie deren Behebung. Ein wesentlicher Bestandteil der Reaktion ist die Sicherheits-Triage: Es muss ermittelt werden, ob die betroffene Software vorhanden ist, ob die angreifbare Stelle erreichbar ist, was ein Angreifer damit anstellen könnte und ob sie bereits ausgenutzt wird. Dadurch wird die Dringlichkeit des Problems bestimmt, wer handeln muss und welche Beweise noch geprüft werden müssen. Eine Schweregradbewertung kann hilfreich sein, aber sie allein kann die Gefahr für ein bestimmtes Produkt nicht bestimmen. Eine Triage-Entscheidung muss überprüft werden, sobald neue Fakten oder Softwareänderungen vorliegen. Wenn die Ausnutzung bereits im Gange ist, müssen möglicherweise Schutzmaßnahmen eingeleitet werden, bevor die Bewertung abgeschlossen ist. [65]
Manchmal existiert noch keine Lösung. Selbst wenn schnell eine veröffentlicht wird, muss sie im Produkt geprüft, auf die Beeinträchtigung wichtiger Funktionen getestet und in der tatsächlich genutzten Version ausgeliefert und verifiziert werden. Während dieser Zeit kann eine bekannte Schwachstelle weiterhin ausgenutzt werden. Der Zugriff muss gegebenenfalls eingeschränkt, eine betroffene Funktion deaktiviert, ein Dienst isoliert oder, falls erforderlich, offline genommen werden. Diese temporären Maßnahmen müssen überwacht und überprüft werden, bis der Fehler behoben ist. Die Installation eines Patches macht einen bereits erfolgten Angriff nicht rückgängig. [65]
Angreifer können schneller agieren, als die Behebung von Sicherheitslücken die Betroffenen erreicht. In Studien zu tatsächlich beobachteten Ausnutzungen von Schwachstellen berichtete Mandiant von durchschnittlichen Ausnutzungszeiten von 63 Tagen für 2018–2019, 32 Tagen für 2021–2022 und fünf Tagen für 2023. Der 2026 veröffentlichte Bericht bezifferte die durchschnittliche Zeit bis zur Ausnutzung für 2025 auf minus sieben Tage (−7 Tage), was bedeutet, dass die erste beobachtete Ausnutzung in den untersuchten Fällen im Durchschnitt vor der Verfügbarkeit von Patches erfolgte. Diese Messungen beziehen sich auf ausgewählte ausgenutzte Schwachstellen und geben nicht die Zeiträume für alle Schwachstellen oder die Installationsgeschwindigkeit von Updates durch Kunden an. Zero-Day-Angriffe beeinflussen die Durchschnittswerte. Die Beschleunigung begann zudem vor dem Aufkommen der heutigen generativen KI-Systeme. [66] [67] [68]
KI-gestützte Analysen verschärfen diesen ohnehin schon schwierigen Wettlauf. Ein veröffentlichter Patch oder eine Quellcodeänderung kann aufdecken, was eine anfällige Version von ihrem Nachfolger unterscheidet. Automatisierte Tools helfen beim Vergleich der Versionen, der Entwicklung von Testkandidaten und der Identifizierung exponierter Systeme, wodurch der Aufwand zur Ausnutzung bekannter Schwachstellen sinken kann. Untersuchungen aus dem Jahr 2024 zeigten, dass ein LLM-basierter Agent unter kontrollierten Bedingungen mehrere zuvor bekannt gewordene Schwachstellen ausnutzen konnte, wenn ihm deren Beschreibungen bekannt wurden. Im September 2026 berichtete Google Threat Intelligence über eine verstärkte Ausnutzung zuvor bekannt gewordener, hochriskanter Schwachstellen und nannte KI-gestützte Analysen als möglichen Faktor – jedoch nicht als Beweis dafür, dass KI jeden Vorfall verursacht hat. [69] [70]
Diese Fähigkeit beschränkt sich nicht auf Modelldienste, deren Betreiber Anfragen überwachen oder einschränken können. Einige leistungsstarke Sprachmodelle werden mit herunterladbaren Gewichten veröffentlicht und können außerhalb der Kontrolle ihrer Entwickler ausgeführt oder modifiziert werden; ihre Schutzmechanismen können fehlen, verändert oder entfernt werden. Öffentliche Evaluierungen im Jahr 2026 zeigten, dass Open-Weight-Modelle bei Cybersicherheitsaufgaben zunehmend leistungsfähiger sind. Das macht jedoch nicht jedes Modell zu einem effektiven Angreifer, noch macht es jede bekannte Schwachstelle leicht ausnutzbar. KI unterstützt Verteidiger auch bei der Codeüberprüfung, der Fehlererkennung und der Vorbereitung von Gegenmaßnahmen. Was sich ändert, sind die Kosten und die potenzielle Geschwindigkeit der Schwachstellensuche, auch für Akteure, die die Einschränkungen eines Modellanbieters nicht beachten müssen. [71] [72]
Die Veröffentlichung eines Fixes bedeutet nicht automatisch, dass er auch bei den Nutzern ankommt. Entwickler, Distributoren und Betreiber müssen die Änderung möglicherweise noch integrieren, testen, freigeben und bereitstellen. Angreifer können nach nicht aktualisierten Installationen suchen, und eine überstürzte Bereitstellung kann neue Fehler verursachen. Schnelle Fehlerbehebung, temporärer Schutz und eine geprüfte Bereitstellung ergänzen sich daher und stehen nicht im Widerspruch zueinander.
Sicheres Design ist gerade deshalb wichtig, weil sich dieses Zeitfenster nicht immer vollständig schließen lässt. Speichersicherer Code kann bestimmte Arten von Speicherfehlern verhindern; strenge Berechtigungen und eine separate Sandbox können den Zugriff einer kompromittierten Komponente einschränken; Eingabe- und Ressourcenbeschränkungen können andere Angriffe erschweren. Solche Schutzmaßnahmen helfen sowohl vor der Entdeckung einer Schwachstelle als auch während der Vorbereitung und des Testens einer Lösung. Die Fähigkeit, bestimmte Fehler zu verkraften, den Schaden zu begrenzen und sich zu erholen, ist Teil der Sicherheitsresilienz; ein für solche Bedingungen ausgelegtes System wird auch als überlebensfähig bezeichnet. Dies ist jedoch kein Beweis dafür, dass anfällige Software sicher ist, und ersetzt niemals die Arbeit der Fehlerbehebung und -verifizierung. [38]
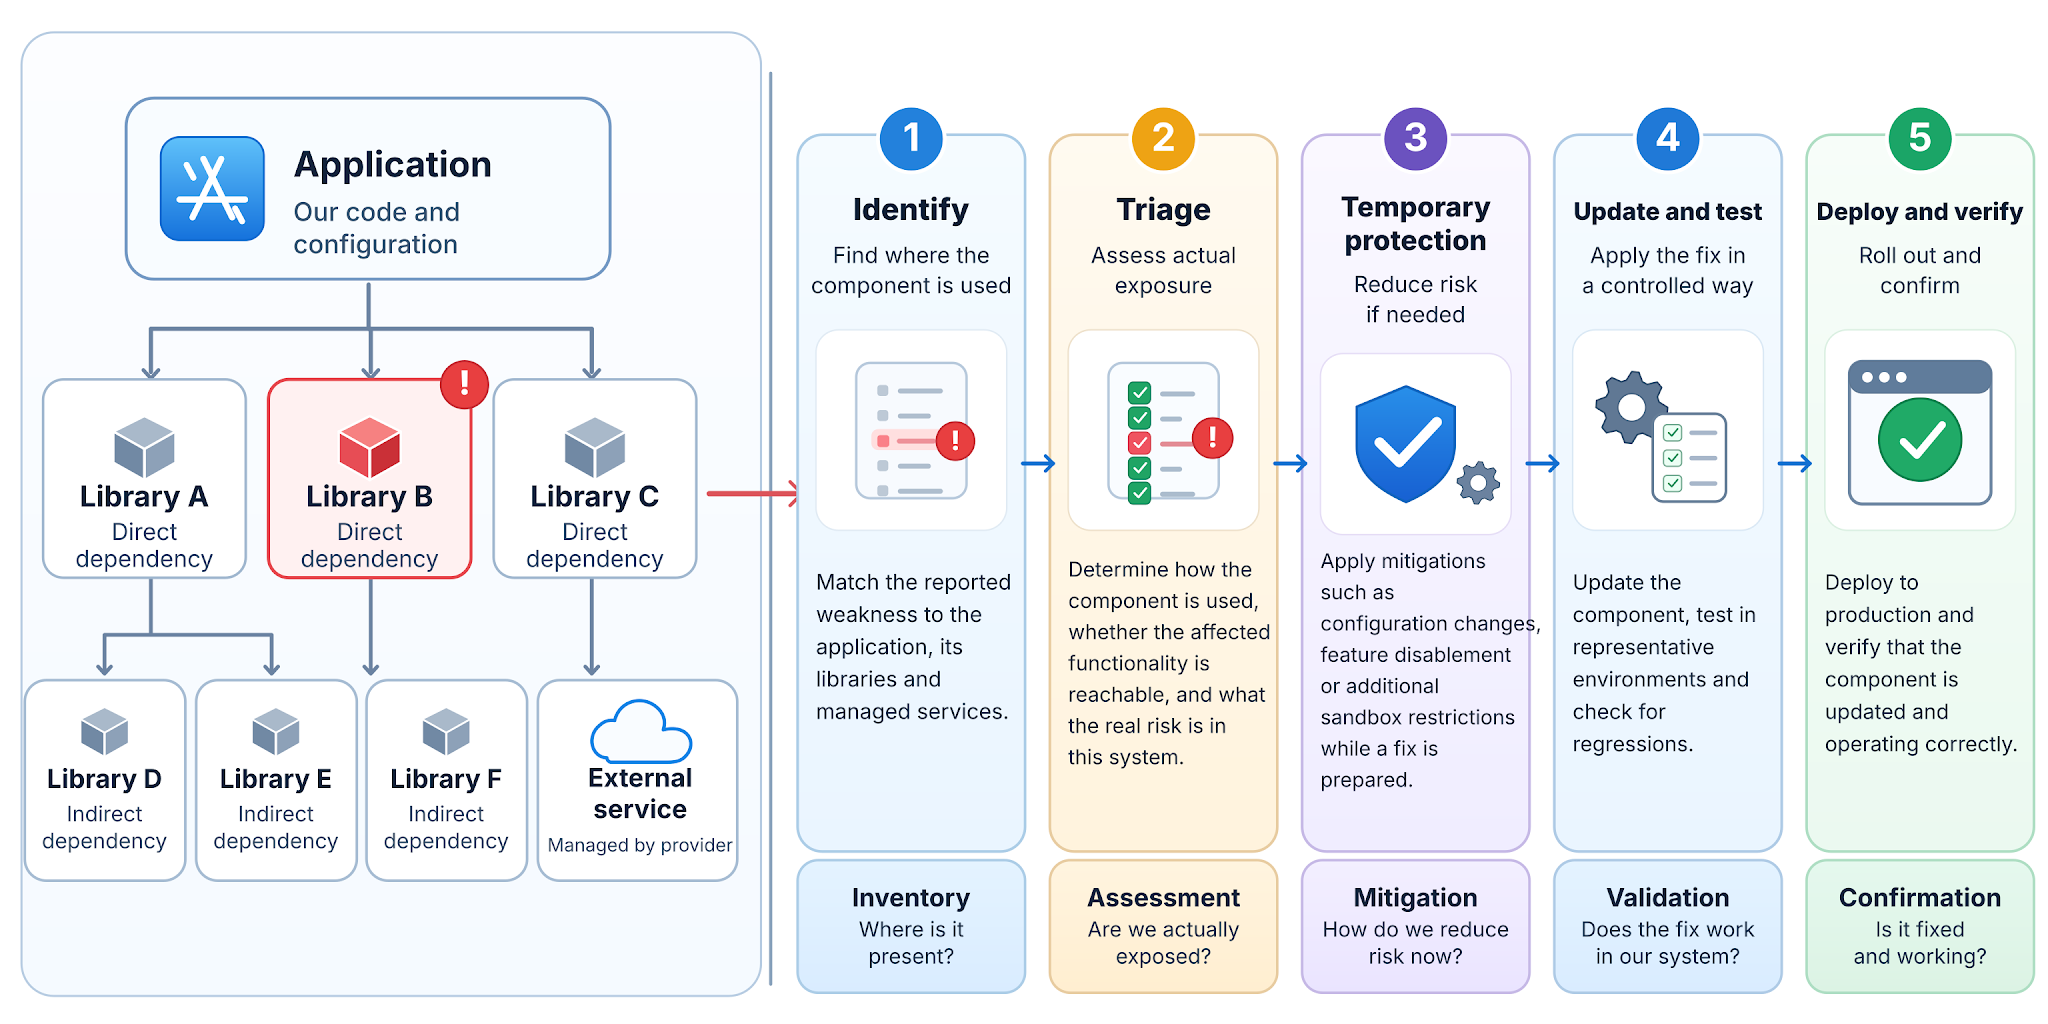
Outsourcing entbindet nicht von diesen Verantwortlichkeiten. Ein Dienstleister kann zwar eine Anwendung entwickeln, einen Cloud-Dienst betreiben, Arbeitsplatzgeräte verwalten oder eine Website pflegen, doch die beauftragende Organisation bleibt weiterhin dafür verantwortlich, das akzeptierte Risikoniveau festzulegen. Manche Dienstleister sind hochkompetent und diszipliniert; andere hingegen verteilen ihre Aufmerksamkeit auf zu viele Kunden oder liefern kaum Nachweise über die Wartung nach der ersten Lieferung. Die entscheidende Schwäche liegt nicht in der bloßen Anwesenheit eines externen Auftragnehmers. Es ist vielmehr eine Konstellation, in der niemand die Systemabhängigkeiten klar identifizieren, Zugriffe genehmigen, Fehler entdecken, Änderungen implementieren, Releases validieren oder im Fehlerfall reagieren kann. Verträge, Leistungsbeschreibungen und Gütesiegel können zwar helfen, Erwartungen zu formulieren, doch sichtbare Wartung und Verantwortlichkeit sind wichtiger als beruhigende Formulierungen. [2]
Open-Source-Software bietet eine wertvolle Form der Überprüfung, da ihr Code über das ursprüngliche Entwicklerteam hinaus geprüft und hinterfragt werden kann. Das gängige Argument, dass viele Menschen den Code untersuchen können, beweist jedoch nicht, dass dies tatsächlich genügend qualifizierte Personen tun oder dass gemeldete Fehler umgehend behoben werden. Open-Source-Projekte reichen von gut finanzierten Organisationen bis hin zu kleinen Teams, die weit verbreitete Komponenten pflegen; auch proprietäre Software variiert stark in Bezug auf Überprüfung und Wartung. Das Sicherheitsupdate von PHP vom Oktober 2026 verdeutlicht diesen Unterschied. Nachdem zwei kritische Schwachstellen behoben wurden, beschrieb die PHP Foundation, wie schwierige technische Abwägungen, ein begrenzter Pool erfahrener Wartungsfachleute und der Entscheidungsprozess die Arbeit an einem zugrundeliegenden Problem verzögert hatten. Sie würdigte auch die Rolle finanzierter Ingenieure und externer Forscher bei der Behebung der Fehler. Die Fehler betrafen beschädigten Speicher nach Ressourcenerschöpfung und veraltete interne Zustände über Anfragen hinweg. Dies verbindet die zuvor besprochenen Speicher- und Fehlerbehandlungsmechanismen mit der spezialisierten Wartung, die für die Reparatur einer weit verbreiteten Laufzeitumgebung erforderlich ist. Es geht nicht darum, dass Open Source grundsätzlich schwächer oder ein proprietäres Produkt sicherer ist. Die Verfügbarkeit des Quellcodes schafft die Möglichkeit zur Überprüfung, während kontinuierliche Expertise, klare Verantwortlichkeiten und effektive Wartung die Erkenntnisse in Schutzmaßnahmen umsetzen. [73]
Software muss auch unter den Bedingungen getestet werden, unter denen sie eingesetzt wird. Eine erfolgreiche Demonstration der Hauptfunktion sagt wenig darüber aus, was passiert, wenn das falsche Konto einen Datensatz anfordert, zwei Operationen in Konflikt geraten, eine Datei fehlerhaft ist oder ein privilegierter Helfer einen unerwarteten Befehl erhält. Die Sicherheitsvalidierung prüft, ob die definierten Anforderungen in der tatsächlich eingesetzten Version und Konfiguration erfüllt sind. Sie kann Code- und Abhängigkeitsprüfungen mit Tests verbotener und zulässiger Operationen sowie der Fehlerbehebung kombinieren. Tests können nicht beweisen, dass keine Schwachstelle vorhanden ist, und ein Testergebnis vom Rechner eines Entwicklers belegt möglicherweise nicht die Einschränkungen eines veröffentlichten Produkts. Umgekehrt ist das Fehlen eines öffentlichen Audits kein Beweis für die Unsicherheit eines Dienstes. Glaubwürdige Beweise geben genau an, was untersucht wurde, welche Version und Konfiguration verwendet wurden, was festgestellt wurde und was weiterhin unklar ist. [2]
Wie man eine Sicherheitswarnung beurteilt
Nachrichtenberichte vermischen oft verschiedene Zustände mit ein und demselben alarmierenden Vokabular. Eine Schwachstelle ist ein Defekt oder ein unsicherer Zustand, der unter bestimmten Umständen Schaden verursachen kann. Eine Sicherheitslücke ist eine Schwachstelle, die ausgenutzt werden kann, um eine Sicherheitsfunktion zu untergraben; ein Exploit ist eine Methode, diese Schwachstelle auszunutzen. Die Behauptung, dass ein Fehler die Ausführung von Remote-Code ermöglicht, bedeutet, dass ein Angreifer unter bestimmten Bedingungen Software zur Codeausführung veranlassen kann. Dies beweist jedoch nicht, dass eine bestimmte Organisation angegriffen wurde oder dass alle ihre Daten entwendet wurden. Ein bestätigter Sicherheitsvorfall ist ein Beweis dafür, dass unbefugter Zugriff oder ein anderes kompromittierendes Ereignis stattgefunden hat, auch wenn das volle Ausmaß möglicherweise noch untersucht wird. Schweregradbezeichnungen, Exploit-Demonstrationen und Vorfallsanalysen beantworten unterschiedliche Fragen und sollten nicht synonym verwendet werden.
Eine öffentliche Schwachstellenkennung, oft als CVE-Nummer angegeben, erleichtert verschiedenen Organisationen die Diskussion über dieselbe gemeldete Schwachstelle. Sie ist weder eine Aufzeichnung aller betroffenen Installationen noch ein Beweis für eine erfolgreiche Ausnutzung. Ein Schweregrad-Score schätzt die Eigenschaften der Schwachstelle anhand eines festgelegten Bewertungsmodells ein; die operative Dringlichkeit hängt weiterhin von der Umgebung und den Möglichkeiten eines Angreifers ab. Der Begriff „Zero-Day“ wird häufig für eine Schwachstelle verwendet, die ausgenutzt wird, bevor ein wirksamer Patch verfügbar ist oder bevor der Systembekämpfer davon Kenntnis erlangt, obwohl die Meldekonventionen variieren. Die Bedeutung liegt in der begrenzten Möglichkeit des Systembekämpfers, die Schwachstelle im Vorfeld zu beheben, nicht in der Mystifizierung des Namens. Eine Jahre alte Schwachstelle mit einem veröffentlichten Patch kann immer noch einen akuten Notfall darstellen, wenn sie auf ungeschützten, nie aktualisierten Systemen ausgenutzt wird. [74] [75]
Der erste Faktor zur Beurteilung der praktischen Schwere einer Sicherheitslücke ist die Erreichbarkeit. Ein Angreifer, der bereits die physische Kontrolle über einen gesperrten Rechner haben muss, steht vor anderen Herausforderungen als jemand, der eine Anfrage an einen öffentlichen Dienst senden kann. Eine Schwachstelle in einer selten genutzten optionalen Funktion unterscheidet sich von derselben Schwachstelle in einem öffentlich zugänglichen Dienst, obwohl in beiden Fällen eine Behebung erforderlich sein kann. Der zweite Faktor ist die Autorität: Die Folgen hängen davon ab, ob der betroffene Code öffentliche Informationen lesen, auf private Datensätze zugreifen, Konten ändern, Befehle ausführen oder einen Administrator über einen delegierten Dienst beeinflussen kann. Der dritte Faktor ist die Sichtbarkeit und der Nachweis: Die betroffene Version muss tatsächlich vorhanden sein, die Schwachstelle muss unter relevanten Bedingungen nutzbar sein, und Berichte über aktive Ausnutzung sind von unmittelbarer Bedeutung als eine rein theoretische Möglichkeit. [1]
Die Behebung des Problems ist der vierte Faktor. Ein Anbieter hat möglicherweise bereits einen Fix veröffentlicht, ein Dienst hat ihn bereitgestellt, oder eine Organisation untersucht noch, welche Systeme betroffen sind. Ein Patch kann den unmittelbaren Fehler beheben, ohne nachzuweisen, dass jedes potenziell kompromittierte System untersucht wurde. Wurde die Schwachstelle vor der Behebung des Problems ausgenutzt, können weitere Untersuchungen, Änderungen der Zugangsdaten und die Wiederherstellung eines vertrauenswürdigen Zustands erforderlich sein. Glaubwürdige Aussagen unterscheiden zwischen einer gefundenen Schwachstelle, einem abgewehrten Angriffsversuch, einem bestätigten unbefugten Zugriff und einem tatsächlich entstandenen Schaden. Unsicherheit ist während eines Vorfalls normal; unbegründete Gewissheit ersetzt keine Beweise. [65]
Diese Unterscheidungen erleichtern auch die Bewertung von Sicherheitsversprechen von Lieferanten und Auftragnehmern. Der Nachweis eines gepflegten Komponenteninventars, klarer Verantwortlichkeiten für Patches, aussagekräftiger Release-Tests, kontrollierter privilegierter Zugriff und eines funktionierenden Incident-Response-Prozesses ist aussagekräftiger als das Versprechen vollständiger Sicherheit. Dieselben Fragen gelten unabhängig davon, ob die Arbeit von einem großen Technologieunternehmen, einem kleinen Entwicklungsteam oder einer externen Agentur durchgeführt wird. Die Unternehmensgröße ist weder ein Beweis für Kompetenz noch ein Indiz für Vernachlässigung. Entscheidend ist die Fähigkeit, ein Problem zu identifizieren, seine Auswirkungen zu erläutern, es zu beheben und sicherzustellen, dass die Korrektur in dem System implementiert ist, auf das die Nutzer tatsächlich angewiesen sind. [2]
Fazit
Softwaresicherheit ist komplex, da eine Operation technisch korrekt sein kann, aber dennoch unter ungünstigen Bedingungen ausgeführt werden kann. Ein System kann ein von einem Betrüger eingegebenes Passwort akzeptieren, ein privilegierter Dienst kann für einen unbefugten Aufrufer aktiv werden, eine Prüfung kann veraltet sein, schädliche Daten können als Code interpretiert werden oder ein Speicherfehler kann eine an anderer Stelle geltende Regel umgehen. Abhängigkeiten, Build-Prozesse, Firmware und Wartung bieten weitere Möglichkeiten, dass Sicherheitsvorkehrungen fehlen oder unwirksam sind. Jeder Fehler hat eine andere Ursache, daher erfordert Vertrauen das Verständnis des Weges vom Einfluss des Angreifers bis zur entsprechenden Folgeaktion.
Die nützlichsten Sicherheitsaussagen sind konkret. Sie legen fest, was geschützt bleiben muss, welche Angreiferfähigkeiten berücksichtigt werden, was die betroffene Komponente bewirken kann, welche Schutzmechanismen unabhängig funktionieren und welche Nachweise aus Tests der veröffentlichten Konfiguration stammen. Sie erläutern außerdem, wie Abhängigkeiten überwacht, gemeldete Schwachstellen priorisiert, Risiken bei der Update-Vorbereitung minimiert und die Bereitstellung verifiziert werden. Entwickler und Betreiber bleiben für die Bereitstellung dieser Schutzmaßnahmen verantwortlich. Anwender der Software müssen keine Sicherheitsexperten werden, um glaubwürdige Antworten zu erhalten, anstatt sich mit einem Label, einem Zertifikat oder einer erfolgreichen Demonstration zufriedenzugeben.
Was Sie wissen sollten:
| Nr. | Begriff | Bedeutung |
|---|---|---|
| 1 | Angriffsfläche | Die Punkte, an denen ein Angreifer eindringen, Eingaben machen, eine Wirkung hervorrufen oder Informationen extrahieren könnte, einschließlich offengelegter Dienste und Schnittstellen. |
| 2 | Authentifizierung | Überprüfung der behaupteten Identität im Rahmen der Garantien der verwendeten Methode. |
| 3 | Autorisierung | Überprüfung, ob ein Akteur unter den entsprechenden Bedingungen eine bestimmte Aktion an einer bestimmten Ressource durchführen darf. |
| 4 | Verfügbarkeit | Ein Dienst, der auch unter den Bedingungen nutzbar bleibt, für die er konzipiert wurde. |
| 5 | Auswirkungsbereich | Die Informationen, Abläufe oder sonstigen Ressourcen, die durch einen Ausfall oder eine Kompromittierung direkt oder indirekt über andere Komponenten beeinträchtigt werden können. |
| 6 | Fehler in der Geschäftslogik | Ein Versäumnis, die zulässige Reihenfolge, Voraussetzungen oder Grenzen einer Operation durchzusetzen, selbst wenn einzelne Anfragen wohlgeformt und authentifiziert sind. |
| 7 | Vertraulichkeit | Die Informationen werden nur an autorisierte Empfänger weitergegeben. |
| 8 | Confused-Deputy-Problem | Eine leistungsfähigere Komponente agiert fälschlicherweise für einen Anfragenden, dem die erforderliche Berechtigung fehlt. |
| 9 | Designschwachstelle | Eine Schwäche in den vorgesehenen Regeln, Berechtigungen, Protokollen oder Arbeitsabläufen eines Systems, die es ermöglicht, eine Sicherheitsanforderung zu verletzen, selbst wenn die Software diesem Design entspricht. |
| 10 | Fail-open (Zulassen bei Prüfausfall) | Ein Fehler in der Fehlerbehandlung, bei dem eine nicht verfügbare oder fehlgeschlagene Sicherheitsprüfung als Erlaubnis zum Fortfahren interpretiert wird. |
| 11 | Härtung | Die Gefährdung eines Systems wird verringert, indem nicht benötigte Dienste und Funktionen deaktiviert, Zugriffe und Berechtigungen eingeschränkt und die implementierten Einstellungen überprüft werden. |
| 12 | Implementierung | Der Code und die Konfiguration, die ein Design oder Protokoll in die Praxis umsetzen; Sicherheitsprüfungen können fehlen, selbst wenn das Design einwandfrei ist. |
| 13 | Injection-Schwachstelle | Schwachstelle, durch die externe Daten die Bedeutung eines Befehls, einer Abfrage oder anderer interpretierter Inhalte verändern, statt ausschließlich als Daten behandelt zu werden. |
| 14 | Missbrauch durch Insider | Schädliche Nutzung eines rechtmäßig gewährten Zugangs, einschließlich der Offenlegung von Informationen oder Handlungen, die über den autorisierten Zweck hinausgehen. |
| 15 | Integrität | Schutz vor unbefugter oder unbeabsichtigter Änderung von Informationen oder des Systemzustands. |
| 16 | Laterale Ausbreitung | Ein Angreifer, der seinen Zugriff von einem ersten Einstiegspunkt auf andere Konten, Dienste oder Systeme ausdehnt. |
| 17 | Prinzip der minimalen Berechtigung | Die Zugriffsrechte und Arbeitsabläufe jeder Person oder Komponente werden auf die für ihre Tätigkeit erforderlichen beschränkt, einschließlich Anfragen an andere Dienste. |
| 18 | Memory Integrity Enforcement (MIE) | Apples Schutzmechanismen auf unterstützten Geräten kombinieren Hardware-Speicherprüfungen mit Software- und Betriebssystembeschränkungen, um bestimmte Speicherbeschädigungsangriffe zu verhindern. |
| 19 | Speichersicherheit | Ungültige Speicheroperationen, einschließlich Zugriffe außerhalb der zulässigen Grenzen und die Nutzung von Speicher außerhalb seiner gültigen Lebensdauer, werden verhindert. Regeln und Prüfungen der sicheren Programmiersprache gewährleisten definierte Schutzmechanismen. |
| 20 | Fehlkonfiguration | Eine Einstellung, die Daten, Dienste, Berechtigungen oder Funktionen offenlegt, die über das hinausgehen, was für den beabsichtigten Gebrauch eines Systems erforderlich ist, einschließlich unnötiger, aktivierter Dienste. |
| 21 | Zeigerauthentifizierung (PAC) | Es werden ausgewählte Zeiger überprüft, um bestimmte Speicherbeschädigungs- und Kontrollflussangriffe zu erschweren; es werden keine Kernelrichtlinien unabhängig durchgesetzt. |
| 22 | Rechteausweitung | Erlangung erweiterter Berechtigungen oder Ausführungsbefugnisse durch Ausnutzung einer Sicherheitslücke, eines fehlenden Zugangs oder einer anderen Schwachstelle. |
| 23 | Protokoll | Regeln für den Nachrichtenaustausch und die erforderlichen Prüfungen zwischen interagierenden Systemen; die sichere Gestaltung und korrekte Implementierung dieser Regeln sind separate Aufgaben. |
| 24 | Erreichbarkeit | Ob ein Angreifer unter den gegebenen Konfigurations- und Einsatzbedingungen Zugriff auf einen betroffenen Vorgang hat. |
| 25 | Sandbox | Vom Betriebssystem festgelegte Beschränkungen für Ressourcen, auf die ein Prozess direkt zugreifen darf. Der Prozess kann jedoch weiterhin indirekte Auswirkungen über andere Dienste haben. |
| 26 | Sicherer Systemstart | Kette von Startprüfungen, bei der ausgehend von einem vertrauenswürdigen Vertrauensanker jede nachfolgende Startphase autorisiert wird. |
| 27 | Secure Enclave | Ein separater Apple-Sicherheitsprozessor mit eigenem Mikrokernel, der Regeln für ausgewählte Geheimnisse und kryptografische Operationen durchsetzt. |
| 28 | Sicherheitsmaßnahme | Durchgesetzter Mechanismus oder Prozess, der eine Sicherheitseigenschaft schützt oder einen möglichen Schadensweg unterbindet. |
| 29 | Sicherheitsresilienz | Die Fähigkeit, Sicherheitsausfälle zu überstehen, einzudämmen und sich davon zu erholen, während gleichzeitig die erforderlichen Dienste erhalten oder wiederhergestellt werden. |
| 30 | Sicherheits-Triage | Beurteilung, ob eine gemeldete Sicherheitslücke die eingesetzte Software betrifft, ob sie erreichbar ist, was sie ermöglichen könnte und wie dringend reagiert werden muss. |
| 31 | Session-Hijacking | Verwendung einer kompromittierten Sitzungskennung oder eines kompromittierten Tokens, um Anfragen als authentifiziertes Konto zu stellen. |
| 32 | Social Engineering | Die Verwendung von Täuschung oder Manipulation, um die Offenlegung von Informationen zu erzwingen, Zugang zu gewähren oder Handlungen zu erreichen, die den Zwecken des Angreifers dienen. |
| 33 | Software-Stückliste (SBOM) | Eine Bestandsaufnahme der Softwarekomponenten und -versionen einschließlich Abhängigkeiten, die zur Beurteilung dient, ob ein gemeldetes Problem vorliegen könnte. |
| 34 | Kompromittierung der Software-Lieferkette | Böswillige Veränderung einer Abhängigkeit, des Quellcodes, des Build-, Release- oder Verteilungsprozesses, um schädlichen Code an nachgelagerte Benutzer zu gelangen. |
| 35 | Bedrohungsmodell | Eine Darstellung dessen, was geschützt werden muss, wie ein Angreifer das System beeinflussen kann, welche Ergebnisse von Bedeutung sind und welche Annahmen den Schutzmaßnahmen zugrunde liegen. |
| 36 | Prüfungs-Nutzungs-Zeitlücke (TOCTOU) | Eine Lücke, in der sich die betreffende Ressource oder der Zustand zwischen Überprüfung und Nutzung ändern kann, wodurch die zuvor getroffene Entscheidung ungültig wird. |
| 37 | Zeitlicher Seitenkanal | Informationsverlust durch messbare Unterschiede im Betriebszeitpunkt anstelle des beabsichtigten Ergebnisses. |
| 38 | Nicht vertrauenswürdige Eingaben | Informationen, deren relevante Eigenschaften für den beabsichtigten Verwendungszweck nicht nachgewiesen wurden, unabhängig davon, ob sie böswillig oder unabsichtlich übermittelt wurden. |
| 39 | Use-after-free (Zugriff nach Speicherfreigabe) | Zugriff auf den Speicher über eine Referenz, nachdem das ursprüngliche Objekt freigegeben wurde, manchmal sogar nachdem dieser Speicher wiederverwendet wurde. |
| 40 | Validierung | Überprüfung, ob eine Eingabe, Anfrage, Operation oder ein System die definierten Anforderungen unter den bewerteten Bedingungen erfüllt. |
Literaturverzeichnis
Im Text werden nummerierte Quellen zitiert. o. J. bedeutet, dass kein Veröffentlichungsdatum angegeben ist.
- National Institute of Standards and Technology (2012). Guide for Conducting Risk Assessments. NIST Special Publication 800-30 Rev. 1. DOI: 10.6028/NIST.SP.800-30r1.
- National Institute of Standards and Technology (2022). Secure Software Development Framework (SSDF) Version 1.1: Recommendations for Mitigating the Risk of Software Vulnerabilities. NIST Special Publication 800-218. DOI: 10.6028/NIST.SP.800-218.
- OWASP Foundation (n.d.). Authentication Cheat Sheet. OWASP Cheat Sheet Series.
- Cybersecurity and Infrastructure Security Agency and Federal Bureau of Investigation (2025). Product Security Bad Practices: Updated Guidance. CISA/FBI advisory, 17 January 2025.
- OWASP Foundation (n.d.). Session Management Cheat Sheet. OWASP Cheat Sheet Series.
- Zhuo, S., Biddle, R., Koh, Y. S., Lottridge, D. and Russello, G. (2023). SoK: Human-centered Phishing Susceptibility. ACM Transactions on Privacy and Security, 26(3), Article 24. DOI: 10.1145/3575797.
- OWASP Foundation (n.d.). Authorization Cheat Sheet. OWASP Cheat Sheet Series.
- Hardy, N. (1988). The Confused Deputy (or Why Capabilities Might Have Been Invented). ACM SIGOPS Operating Systems Review, 22(4), pp. 36–38. DOI: 10.1145/54289.871709.
- OWASP Foundation (n.d.). Authorization Patterns Cheat Sheet. OWASP Cheat Sheet Series.
- The Chromium Project (n.d.). Sandbox Design. Chromium design documentation.
- National Institute of Standards and Technology (n.d.). Insider Threat. NIST CSRC Glossary.
- OWASP Foundation (n.d.). Business Logic Security Cheat Sheet. OWASP Cheat Sheet Series.
- MITRE (n.d.). CWE-367: Time-of-check Time-of-use (TOCTOU) Race Condition. Common Weakness Enumeration.
- OWASP Foundation (n.d.). Input Validation Cheat Sheet. OWASP Cheat Sheet Series.
- OWASP Foundation (n.d.). SQL Injection Prevention Cheat Sheet. OWASP Cheat Sheet Series.
- OWASP Foundation (n.d.). Cross Site Scripting Prevention Cheat Sheet. OWASP Cheat Sheet Series.
- The Rust Project (n.d.). The Rust Programming Language: References and Borrowing; Unsafe Rust. Rust language documentation.
- The Swift Project (n.d.). Memory Safety. The Swift Programming Language, Swift.org.
- Python Software Foundation (n.d.). Extending and Embedding the Python Interpreter. Python 3 documentation.
- Szekeres, L., Payer, M., Wei, T. and Song, D. (2013). SoK: Eternal War in Memory. IEEE Symposium on Security and Privacy, pp. 48–62. DOI: 10.1109/SP.2013.13.
- Anderson, R. (1993). Why Cryptosystems Fail. Proceedings of the 1st ACM Conference on Computer and Communications Security, pp. 215–227. DOI: 10.1145/168588.168615.
- Internet Engineering Task Force (2023). Service Identity in TLS. RFC 9525.
- Internet Engineering Task Force (2020). JSON Web Token Best Current Practices. RFC 8725.
- Rescorla, E. (2018). The Transport Layer Security (TLS) Protocol Version 1.3. IETF RFC 8446. DOI: 10.17487/RFC8446.
- Clark, J. and van Oorschot, P. C. (2013). SoK: SSL and HTTPS: Revisiting Past Challenges and Evaluating Certificate Trust Model Enhancements. IEEE Symposium on Security and Privacy. DOI: 10.1109/SP.2013.41.
- National Institute of Standards and Technology (n.d.). Side Channel. NIST CSRC Glossary.
- Anderson, R. and Needham, R. (1995). Programming Satan's Computer. In Computer Science Today, pp. 426–440. DOI: 10.1007/BFB0015258.
- Kim, Y., et al. (2014). Flipping Bits in Memory Without Accessing Them: An Experimental Study of DRAM Disturbance Errors. Proceedings of the 41st International Symposium on Computer Architecture, pp. 361–372. DOI: 10.1109/ISCA.2014.6853210.
- Seaborn, M. and Dullien, T. (2015). Exploiting the DRAM Rowhammer Bug to Gain Kernel Privileges. Google Project Zero research, March 2015.
- Kocher, P., et al. (2018). Spectre Attacks: Exploiting Speculative Execution. arXiv:1801.01203, security research preprint.
- Lipp, M., et al. (2018). Meltdown: Reading Kernel Memory from User Space. 27th USENIX Security Symposium.
- Intel (n.d.). Analysis of Speculative Execution Side Channels. Intel Software Security Guidance.
- NVIDIA (2018). Security Notice: NVIDIA Tegra RCM Vulnerability. NVIDIA Product Security Notice, 24 April 2018.
- Temkin, K. and ReSwitched (2018). Fusée Gelée: Boot ROM Vulnerability Disclosure. Research disclosure.
- National Institute of Standards and Technology (2018). Platform Firmware Resiliency Guidelines. NIST Special Publication 800-193. DOI: 10.6028/NIST.SP.800-193.
- Glosner, C. and Machiry, A. (2026). SoK: All You Ever Wanted to Know About Bootloader Security but Were Afraid to Ask. IEEE Symposium on Security and Privacy. DOI: 10.1109/SP63933.2026.00163.
- Lefeuvre, H., Dautenhahn, N., Chisnall, D. and Olivier, P. (2025). SoK: Software Compartmentalization. IEEE Symposium on Security and Privacy. DOI: 10.1109/SP61157.2025.00075.
- Ross, R., Pillitteri, V., Graubart, R., Bodeau, D. and McQuaid, R. (2021). Developing Cyber-Resilient Systems: A Systems Security Engineering Approach. NIST Special Publication 800-160, Vol. 2 Rev. 1. DOI: 10.6028/NIST.SP.800-160v2r1.
- Apple (n.d.). Operating System Integrity. Apple Platform Security.
- Apple Security Research (2025). Memory Integrity Enforcement: A Complete Vision for Memory Safety in Apple Devices. Apple Security Research technical blog.
- Apple (n.d.). Secure Enclave. Apple Platform Security.
- Apple Developer (n.d.). Protecting Keys with the Secure Enclave. Apple Developer Documentation, Security.
- Microsoft (n.d.). Trusted Platform Module (TPM) fundamentals. Microsoft Learn.
- Arm (n.d.). TrustZone for Cortex-A. Arm Technologies.
- Intel (n.d.). Intel Software Guard Extensions SDK for Linux OS. Intel Developer Documentation.
- Zinkus, M., Jois, T. M. and Green, M. (2022). SoK: Cryptographic Confidentiality of Data on Mobile Devices. Proceedings on Privacy Enhancing Technologies, 2022(1), pp. 586–607. DOI: 10.2478/popets-2022-0029.
- Apple Developer (n.d.). Enabling Enhanced Security for Your App. Apple Developer Documentation, Xcode.
- Apple Developer (n.d.). Preparing Your App to Work with Pointer Authentication. Apple Developer Documentation, Security.
- LLVM Project (n.d.). Pointer Authentication. Clang Compiler Documentation.
- OWASP Foundation (2025). A10: Mishandling of Exceptional Conditions. OWASP Top 10: 2025.
- MITRE (n.d.). Privilege Escalation (TA0004). MITRE ATT&CK knowledge base.
- MITRE (n.d.). Lateral Movement (TA0008). MITRE ATT&CK knowledge base.
- OWASP Foundation (2025). A03: Software Supply Chain Failures. OWASP Top 10: 2025.
- Cybersecurity and Infrastructure Security Agency and international partners (2026). 2026 Minimum Elements for a Software Bill of Materials (SBOM). Joint government guidance.
- Abu Ishgair, E., Gomez, J., Melara, M. S., Cárdenas, A. A. and Torres-Arias, S. (2026). SoK: A Defense-Oriented Evaluation of Software Supply Chain Security. IEEE European Symposium on Security and Privacy, pp. 836–859. DOI: 10.1109/EuroSP68448.2026.00059.
- Boyens, J., et al. (2024). Cybersecurity Supply Chain Risk Management Practices for Systems and Organizations. NIST SP 800-161 Rev. 1, Update 1.
- Arasaratnam, O., et al. (2024). xz Backdoor CVE-2024-3094. Open Source Security Foundation, 30 March 2024.
- Cox, R. (2024). Timeline of the xz Open Source Attack. Research note, 2024.
- Supply-chain Levels for Software Artifacts (n.d.). Provenance. SLSA Specification, version 1.2.
- Supply-chain Levels for Software Artifacts (n.d.). Build: Verifying Artifacts. SLSA Specification, version 1.2.
- The Update Framework (2024). Overview. TUF Documentation, last updated October 2024.
- Rekhi, S., Amberiadis, K., Akib, A. A., and Srivastava, A. (2025). Analyzing Collusion Threats in the Semiconductor Supply Chain. NIST Cybersecurity White Paper 46. DOI: 10.6028/NIST.CSWP.46.
- National Institute of Standards and Technology (n.d.). Supply Chain. NIST Mobile Threat Catalogue.
- Cybersecurity and Infrastructure Security Agency (n.d.). Known Exploited Vulnerabilities Catalog. CISA vulnerability catalogue.
- UK National Cyber Security Centre (n.d.). Vulnerability Management: Carry Out Assessments. NCSC vulnerability management guidance.
- Charrier, C., and Semrau, J. (2023). Analysis of Time-to-Exploit Trends: 2021–2022. Mandiant / Google Threat Intelligence, 28 September 2023.
- Charrier, C., and Weiner, R. (2024). How Low Can You Go? An Analysis of 2023 Time-to-Exploit Trends. Mandiant / Google Threat Intelligence, 15 October 2024.
- Mandiant (2026). M-Trends 2026: Data, Insights, and Strategies From the Frontlines. Google Threat Intelligence.
- Fang, R., Bindu, R., Gupta, A., and Kang, D. (2024). LLM Agents Can Autonomously Exploit One-Day Vulnerabilities. arXiv preprint 2404.08144.
- Grunewald, R., Mazumdar, S., and Vanderlee, K. (2026). Vulnerability Discovery and Exploitation Trends in the AI Era. Google Threat Intelligence Group, 1 October 2026.
- UK AI Security Institute (2026). How Far Behind the Frontier Are Leading Open-Weight Models on Cyber? AISI Work.
- International AI Safety Report (2026). International AI Safety Report 2026. Section 3.4, Open-weight models.
- The PHP Foundation (2026). Today's PHP Security Release, and How We're Strengthening PHP Security. The PHP Foundation Blog, 21 October 2026.
- CVE Program (n.d.). Common Vulnerabilities and Exposures: CVE Program Mission and Records. CVE Program.
- FIRST (n.d.). Common Vulnerability Scoring System (CVSS) v4.0: User Guide. FIRST.org, document version 1.2.